(주)에버스톤 · 부산 해운대 BCC 613호

닉네임 필터를 정규식 한 줄로 믿지 마라 — 유니코드 우회 공격 방어

'admin'과 똑같이 생긴 키릴 문자, 한글 자모를 쪼개는 조합형 우회, 보이지 않는 제어 문자까지. 글로벌 게임의 닉네임·채팅 필터가 뚫리는 이유와 다계층 방어 파이프라인을 정리했습니다.
에버스톤13분 분량AI · 개발게임 개발 · 퍼블리싱
닉네임 필터를 정규식 한 줄로 믿지 마라 — 유니코드 우회 공격 방어 대표 이미지

닉네임 필터를 정규식 하나로 막았다고 안심하는 순간 뚫립니다. 눈에는 admin과 똑같이 보이는 글자가 사실은 전혀 다른 유니코드 문자일 수 있고, 한글은 자음·모음이 결합하는 구조라 단순 단어 매칭이 무력화됩니다. 이 글은 글로벌 서비스에서 실제로 겪는 우회 기법과 방어 구조를 정리합니다.

이 문서는 NotebookLM(노트북 LM)으로 자료를 조사해 만든 문서입니다.

  • 문자열 길이와 실제 글자 수는 일치하지 않습니다. 눈에 보이는 것을 믿으면 안 됩니다
  • 핵심 원칙은 조기 정규화, 후기 검증입니다. 저장 전 여러 단계를 거칩니다
  • 한글은 11,172개의 완성형 음절을 68개 자모로 쪼개서 분석해야 우회를 잡습니다
  • 보이지 않는 제어 문자, 다른 언어의 닮은 글자가 필터를 피해 가는 주요 통로입니다
  • 완벽한 필터링은 불가능하지만, 완벽에 가까운 아키텍처는 만들 수 있습니다

눈에 보이는 것을 믿을 수 없다
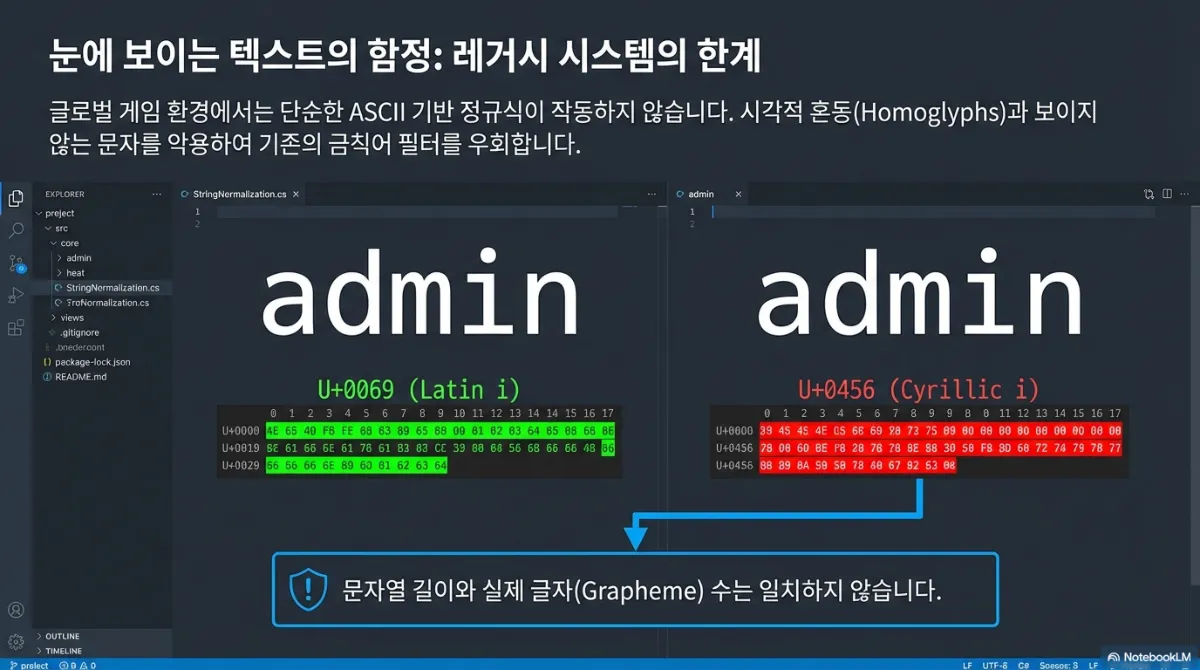
눈에 보이는 텍스트의 함정 슬라이드. 글로벌 게임 환경에서는 단순한 ASCII 기반 정규식이 작동하지 않으며 시각적 혼동(Homoglyphs)과 보이지 않는 문자를 악용해 기존의 금칙어 필터를 우회한다는 설명. 왼쪽은 라틴 문자 i(U+0069)로 만든 admin, 오른쪽은 키릴 문자 i(U+0456)로 만든 admin이 화면에 똑같이 보이지만 내부 바이트 값은 완전히 다르다는 비교. 아래 경고는 문자열 길이와 실제 글자(Grapheme) 수는 일치하지 않는다는 것

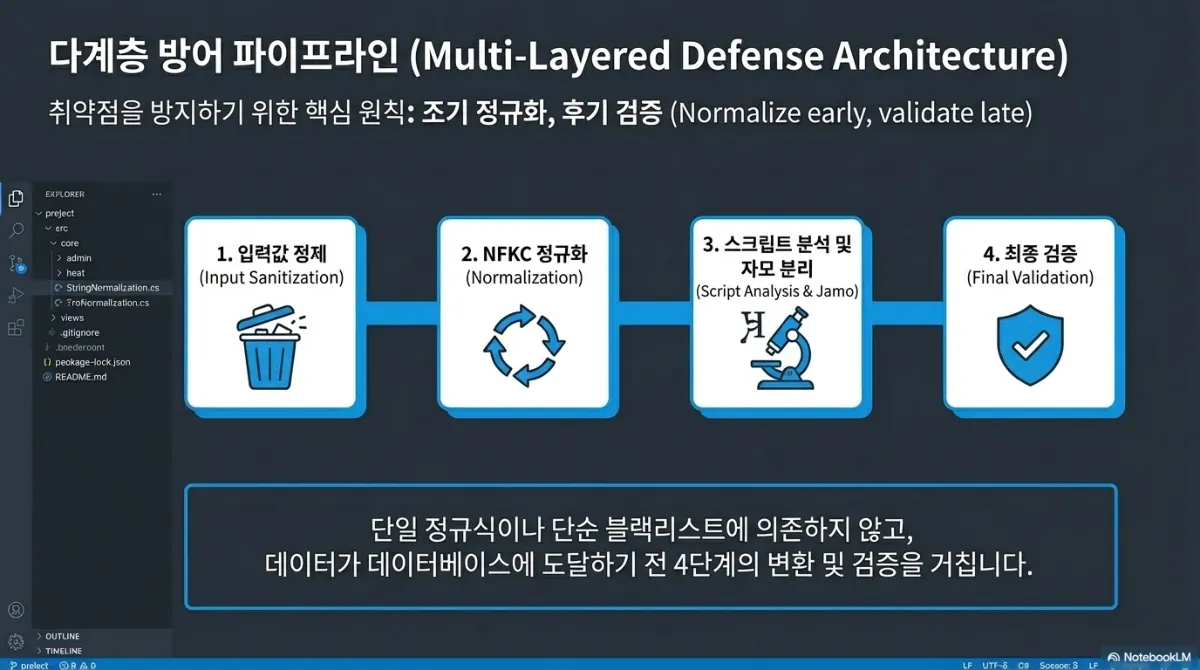
원칙 — 조기 정규화, 후기 검증

다계층 방어 파이프라인 도식. 취약점을 방지하기 위한 핵심 원칙은 조기 정규화, 후기 검증(Normalize early, validate late)이라는 설명과 함께, 1 입력값 정제(Input Sanitization) → 2 NFKC 정규화(Normalization) → 3 스크립트 분석 및 자모 분리(Script Analysis & Jamo) → 4 최종 검증(Final Validation)의 4단계. 단일 정규식이나 단순 블랙리스트에 의존하지 않고 데이터가 데이터베이스에 도달하기 전 4단계의 변환 및 검증을 거친다는 설명

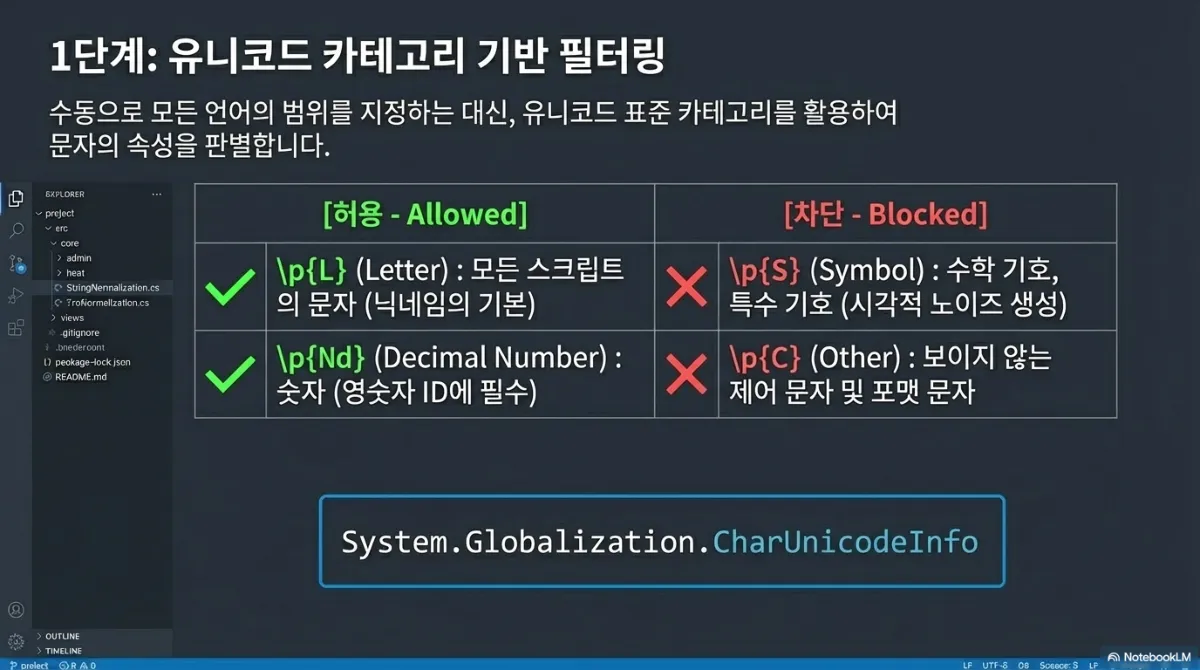
1단계 — 유니코드 카테고리로 걸러낸다

1단계 유니코드 카테고리 기반 필터링 슬라이드. 수동으로 모든 언어의 범위를 지정하는 대신 유니코드 표준 카테고리를 활용해 문자의 속성을 판별한다는 설명. 허용(Allowed)은 \p{L}(Letter, 모든 스크립트의 문자, 닉네임의 기본)과 \p{Nd}(Decimal Number, 숫자, 영숫자 ID에 필수). 차단(Blocked)은 \p{S}(Symbol, 수학 기호·특수 기호, 시각적 노이즈 생성)와 \p{C}(Other, 보이지 않는 제어 문자 및 포맷 문자). 아래 System.Globalization.CharUnicodeInfo 코드 참조

언어마다 허용 범위를 일일이 지정하는 방식은 새 언어가 추가될 때마다 구멍이 생깁니다. 문자의 속성(카테고리)으로 판단하는 방식이 유지보수 측면에서 훨씬 안전합니다.
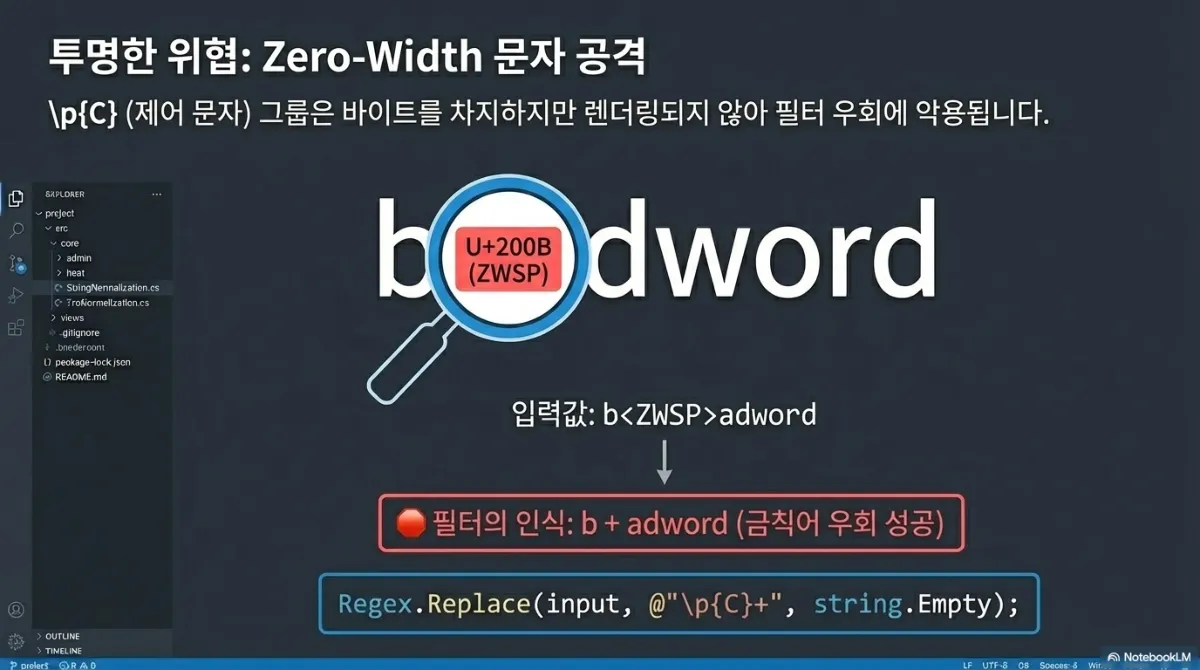
투명한 위협 Zero-Width 문자 공격 슬라이드. \p{C}(제어 문자) 그룹은 바이트를 차지하지만 렌더링되지 않아 필터 우회에 악용된다는 설명. b 와 dword 사이에 U+200B(ZWSP, 폭 없는 공백)를 끼워 넣으면 화면에는 badword로 보이지만 필터는 b와 adword로 인식해 금칙어 우회에 성공하는 예시. 대응 코드는 Regex.Replace(input, @"\p{C}+", string.Empty)

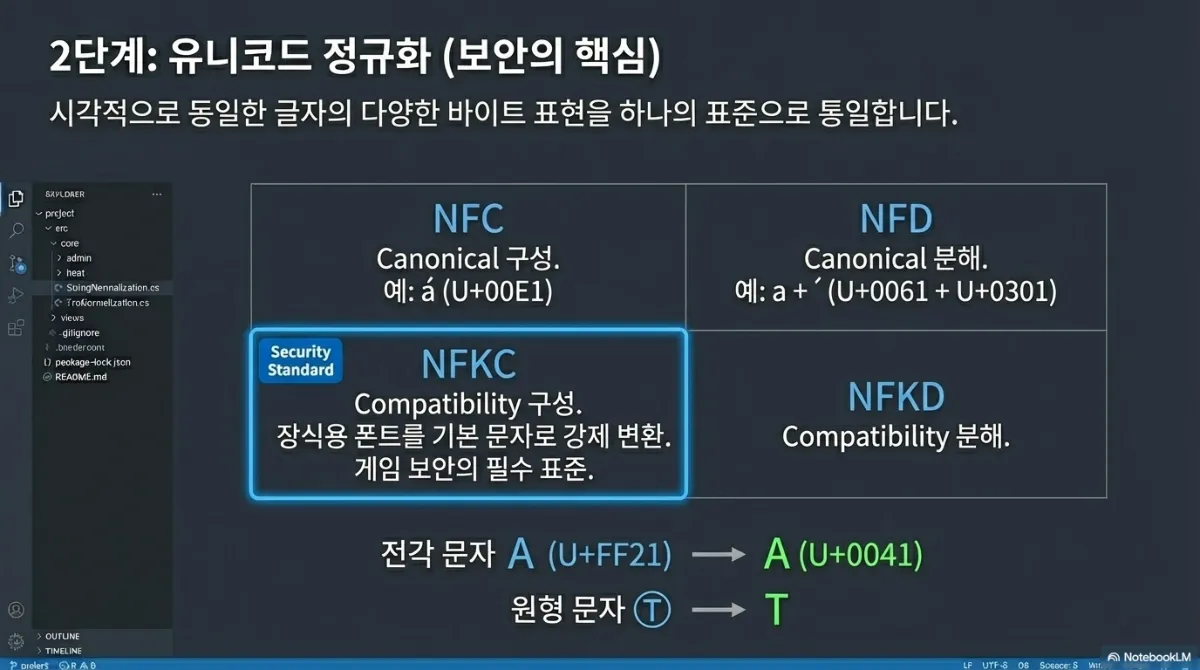
2단계 — 유니코드 정규화

2단계 유니코드 정규화 슬라이드. 시각적으로 동일한 글자의 다양한 바이트 표현을 하나의 표준으로 통일한다는 설명. NFC(Canonical 구성), NFD(Canonical 분해), NFKD(Compatibility 분해), 그리고 Security Standard로 강조된 NFKC(Compatibility 구성) — 장식용 폰트를 기본 문자로 강제 변환하는 게임 보안의 필수 표준. 전각 문자 A(U+FF21)를 A(U+0041)로, 원형 문자 Ⓣ를 T로 변환하는 예시

멋 부린 특수 유니코드 글꼴로 금칙어를 쓰는 경우가 흔합니다. NFKC 정규화 한 단계만 넣어도 이런 시도의 상당수가 걸러집니다.

3단계 — 한글이라는 난제
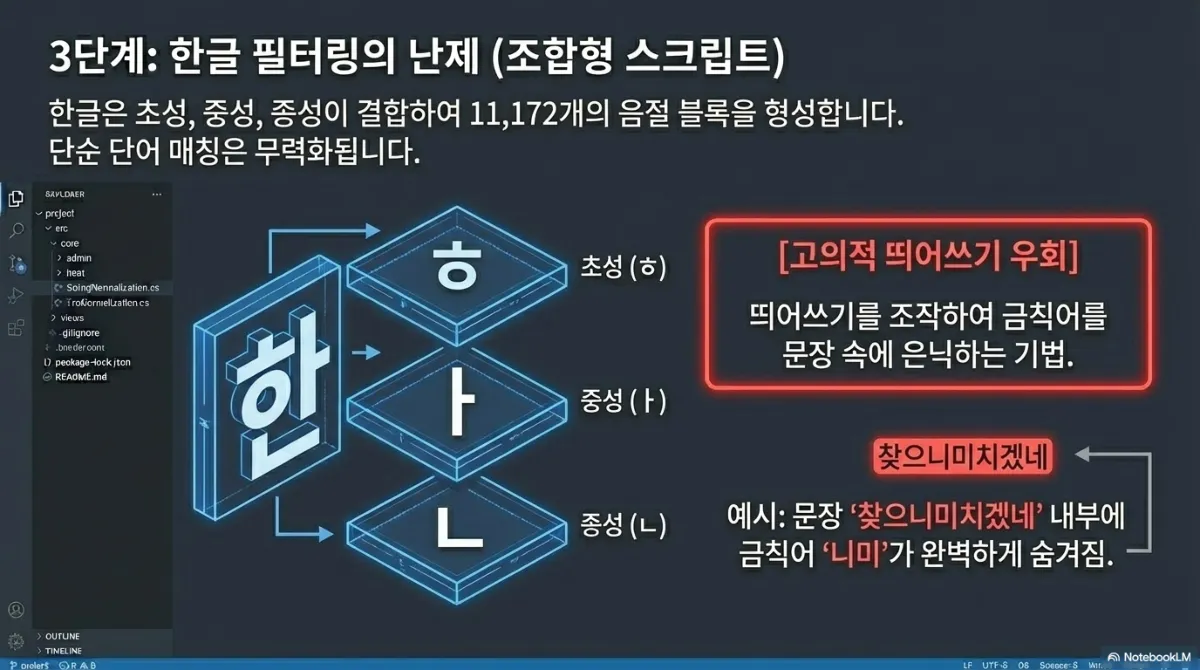
3단계 한글 필터링의 난제 슬라이드. 한글은 초성·중성·종성이 결합하여 11,172개의 음절 블록을 형성하며 단순 단어 매칭은 무력화된다는 설명. '한'이 초성(ㅎ)·중성(ㅏ)·종성(ㄴ)으로 분해되는 도식과, 고의적 띄어쓰기 우회(띄어쓰기를 조작하여 금칙어를 문장 속에 은닉하는 기법) 사례로 '찾으니미치겠네'라는 문장 내부에 금칙어 '니미'가 완벽하게 숨겨진 예시

한글 특유의 조합 구조 때문에 영어권에서 만든 필터 라이브러리를 그대로 가져다 쓰면 대부분 뚫립니다. 국내 서비스라면 이 단계를 반드시 별도로 구현해야 합니다.
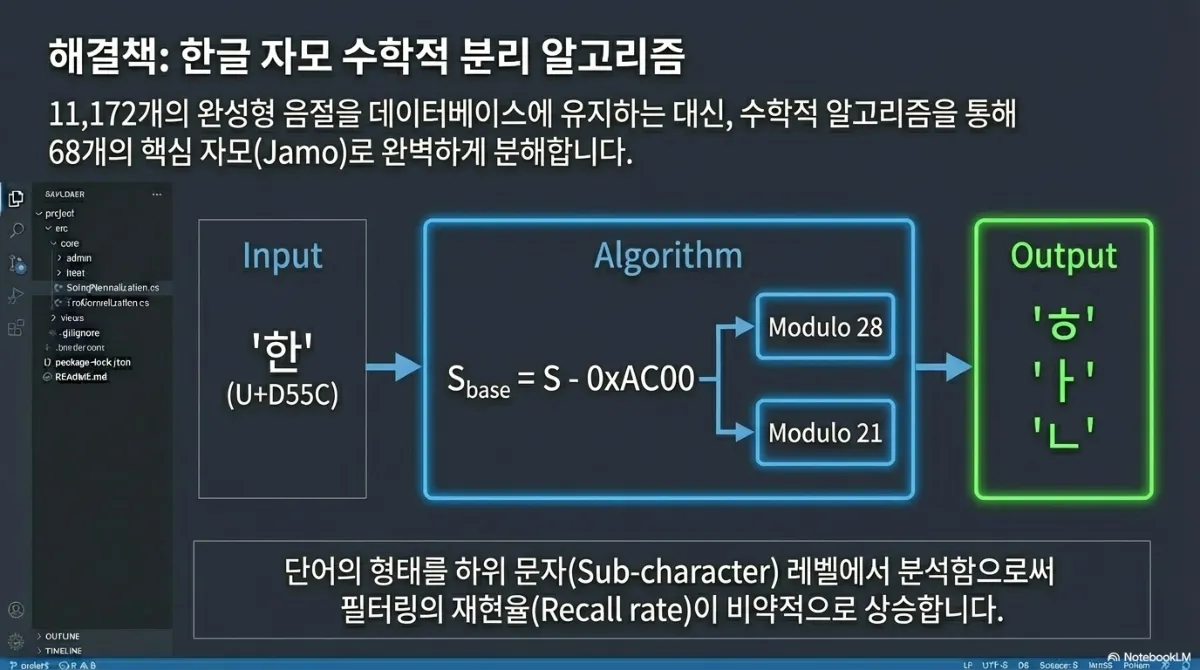
해결책 한글 자모 수학적 분리 알고리즘 슬라이드. 11,172개의 완성형 음절을 데이터베이스에 유지하는 대신 수학적 알고리즘을 통해 68개의 핵심 자모로 완벽하게 분해한다는 설명. Input '한'(U+D55C) → Algorithm(S_base = S - 0xAC00, Modulo 28, Modulo 21) → Output 'ㅎ' 'ㅏ' 'ㄴ'. 단어의 형태를 하위 문자 레벨에서 분석함으로써 필터링의 재현율이 비약적으로 상승한다는 설명

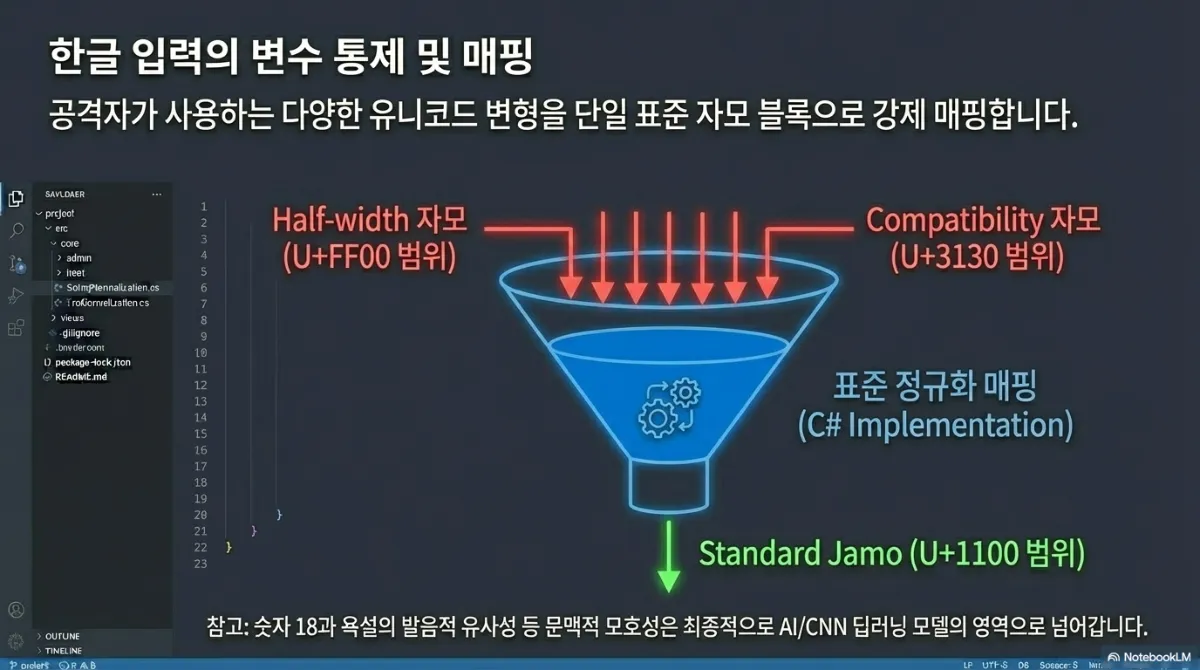
한글 입력의 변수 통제 및 매핑 도식. 공격자가 사용하는 다양한 유니코드 변형(Half-width 자모 U+FF00 범위, Compatibility 자모 U+3130 범위)을 깔때기를 통해 표준 정규화 매핑(C# Implementation)으로 걸러 Standard Jamo(U+1100 범위)로 강제 매핑한다는 도식. 아래 참고는 숫자 18과 욕설의 발음적 유사성 등 문맥적 모호성은 최종적으로 AI/CNN 딥러닝 모델의 영역으로 넘어간다는 것

마지막 문장이 현실적인 한계를 짚어 줍니다. 구조적 우회는 알고리즘으로 잡히지만, 문맥적 은어는 결국 별도의 판단 모델이 필요합니다.

4단계 — 언어를 섞은 위장
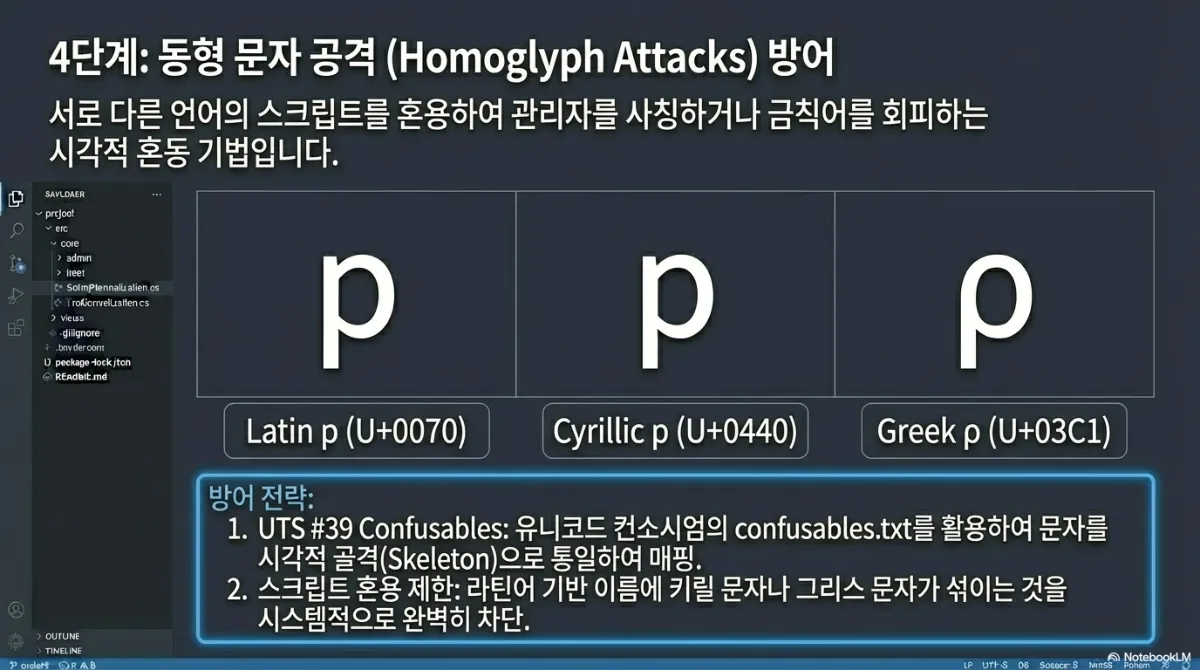
4단계 동형 문자 공격(Homoglyph Attacks) 방어 슬라이드. 서로 다른 언어의 스크립트를 혼용하여 관리자를 사칭하거나 금칙어를 회피하는 시각적 혼동 기법이라는 설명. 라틴 p(U+0070), 키릴 p(U+0440), 그리스 ρ(U+03C1)가 모두 똑같이 보이는 비교. 방어 전략은 1 UTS #39 Confusables(유니코드 컨소시엄의 confusables.txt를 활용해 문자를 시각적 골격으로 통일해 매핑), 2 스크립트 혼용 제한(라틴어 기반 이름에 키릴 문자나 그리스 문자가 섞이는 것을 시스템적으로 완벽히 차단)

관리자 사칭 닉네임 문제의 상당수가 이 기법입니다. 한 닉네임 안에 서로 다른 스크립트가 섞여 있으면 그 자체를 의심 신호로 보는 규칙이 유용합니다.

성능 — 실시간으로 처리하려면
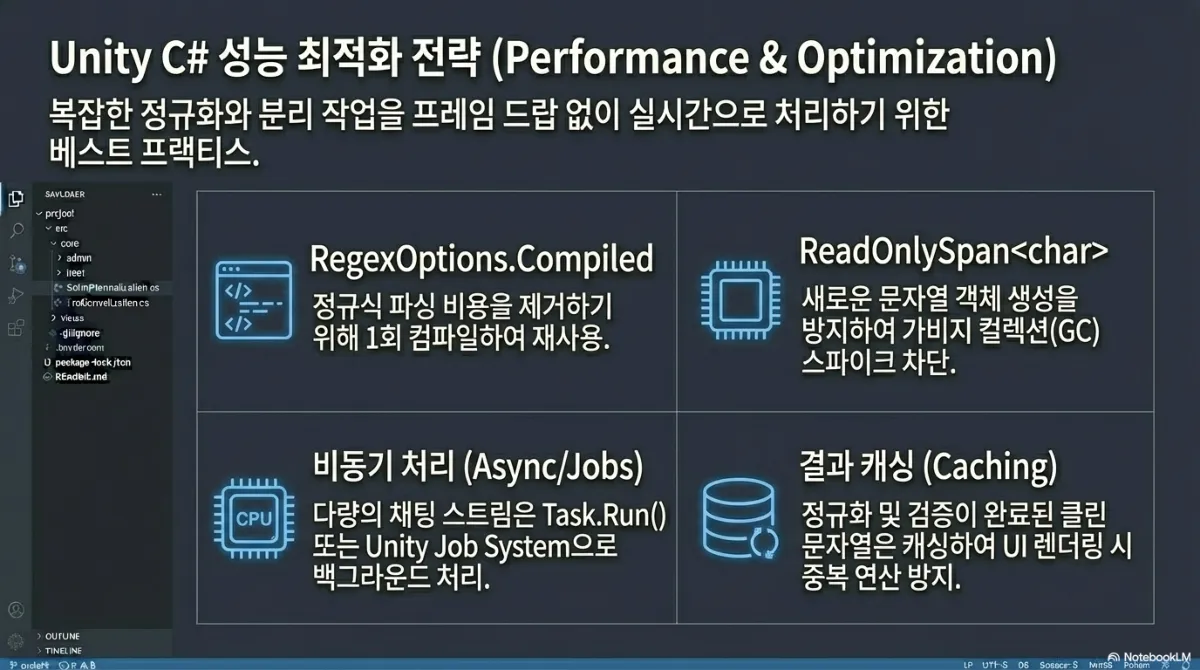
Unity C# 성능 최적화 전략 슬라이드. 복잡한 정규화와 분리 작업을 프레임 드랍 없이 실시간으로 처리하기 위한 방법. RegexOptions.Compiled(정규식 파싱 비용을 제거하기 위해 1회 컴파일하여 재사용), ReadOnlySpan<char>(새로운 문자열 객체 생성을 방지하여 가비지 컬렉션 스파이크 차단), 비동기 처리(다량의 채팅 스트림은 Task.Run() 또는 Unity Job System으로 백그라운드 처리), 결과 캐싱(정규화 및 검증이 완료된 클린 문자열은 캐싱하여 UI 렌더링 시 중복 연산 방지)

방법론 비교

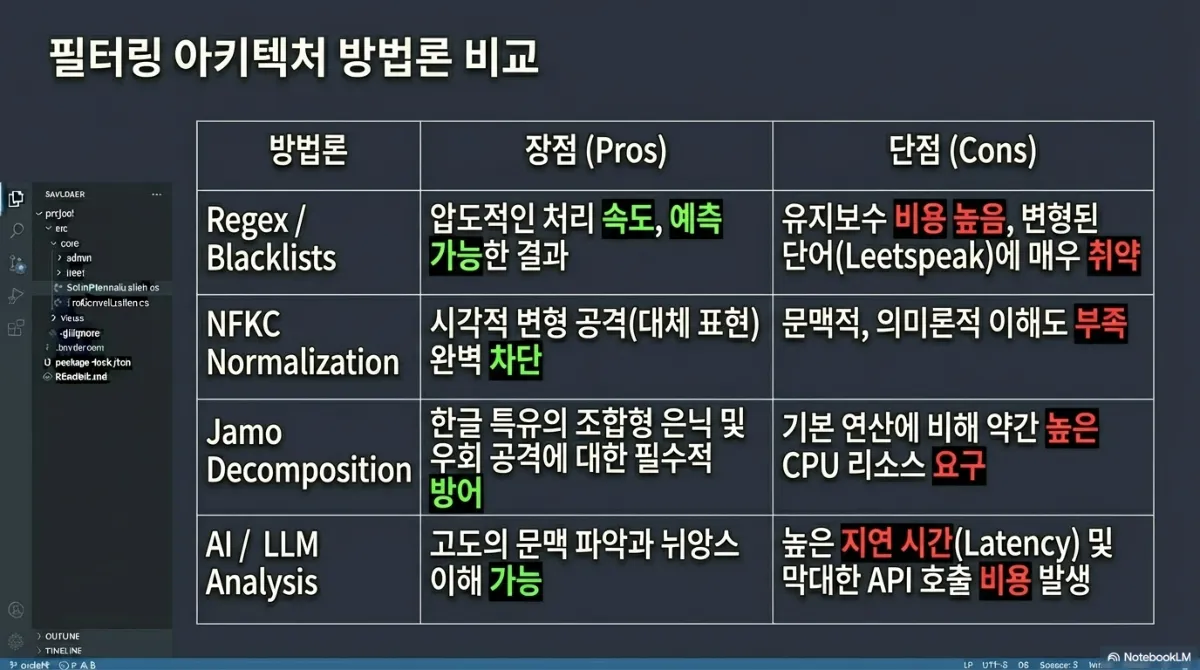
필터링 아키텍처 방법론 비교표. Regex/Blacklists는 압도적인 처리 속도와 예측 가능한 결과가 장점이지만 유지보수 비용이 높고 변형된 단어(리트스피크)에 매우 취약. NFKC Normalization은 시각적 변형 공격을 완벽 차단하지만 문맥적·의미론적 이해도가 부족. Jamo Decomposition은 한글 특유의 조합형 은닉 및 우회 공격에 대한 필수적 방어이지만 기본 연산에 비해 약간 높은 CPU 리소스 요구. AI/LLM Analysis는 고도의 문맥 파악과 뉘앙스 이해가 가능하지만 높은 지연 시간과 막대한 API 호출 비용 발생

이 표가 실무 결정에 유용합니다. 모든 것을 AI로 처리하려 하면 비용과 지연이 감당되지 않고, 정규식만 쓰면 우회에 뚫립니다. 앞 세 단계를 기본기로 깔고, AI는 애매한 사례에만 보조로 씁니다.

클라이언트와 서버의 역할 분담
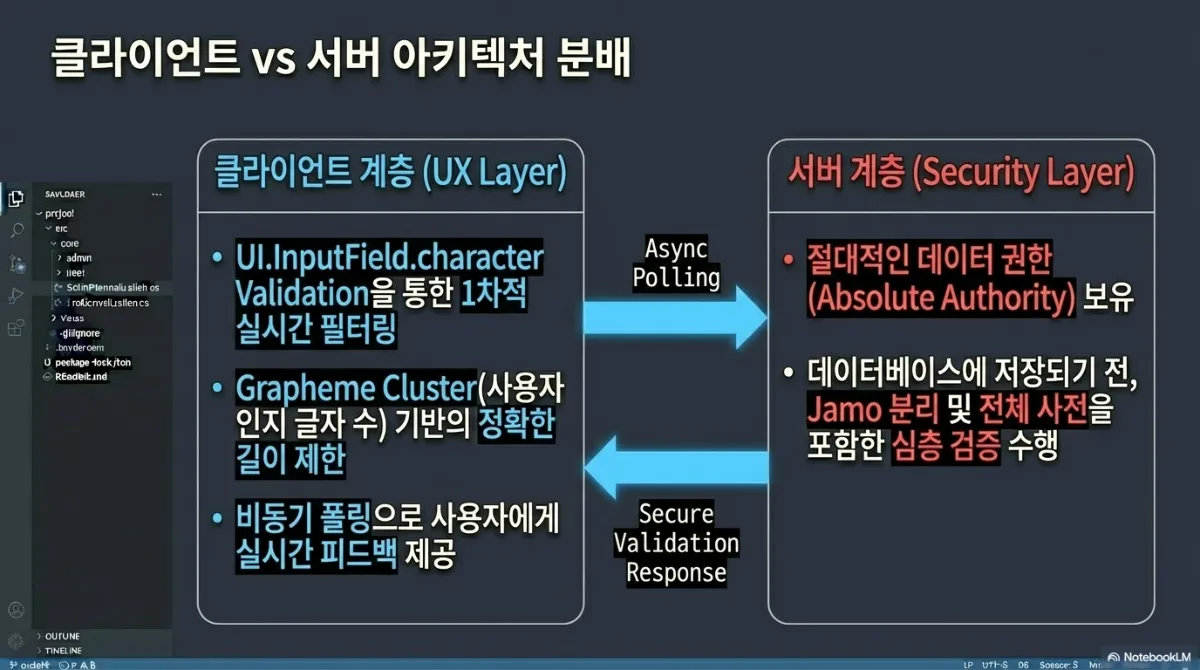
클라이언트 vs 서버 아키텍처 분배 도식. 클라이언트 계층(UX Layer)은 UI.InputField.characterValidation을 통한 1차적 실시간 필터링, Grapheme Cluster(사용자 인지 글자 수) 기반의 정확한 길이 제한, 비동기 폴링으로 사용자에게 실시간 피드백 제공을 담당. 서버 계층(Security Layer)은 절대적인 데이터 권한을 보유하고, 데이터베이스에 저장되기 전 자모 분리 및 전체 사전을 포함한 심층 검증을 수행

클라이언트 검증만 믿으면 위험합니다. 최종 판단은 반드시 서버에서 해야 하고, 클라이언트 쪽은 사용자 경험을 위한 1차 필터일 뿐입니다.
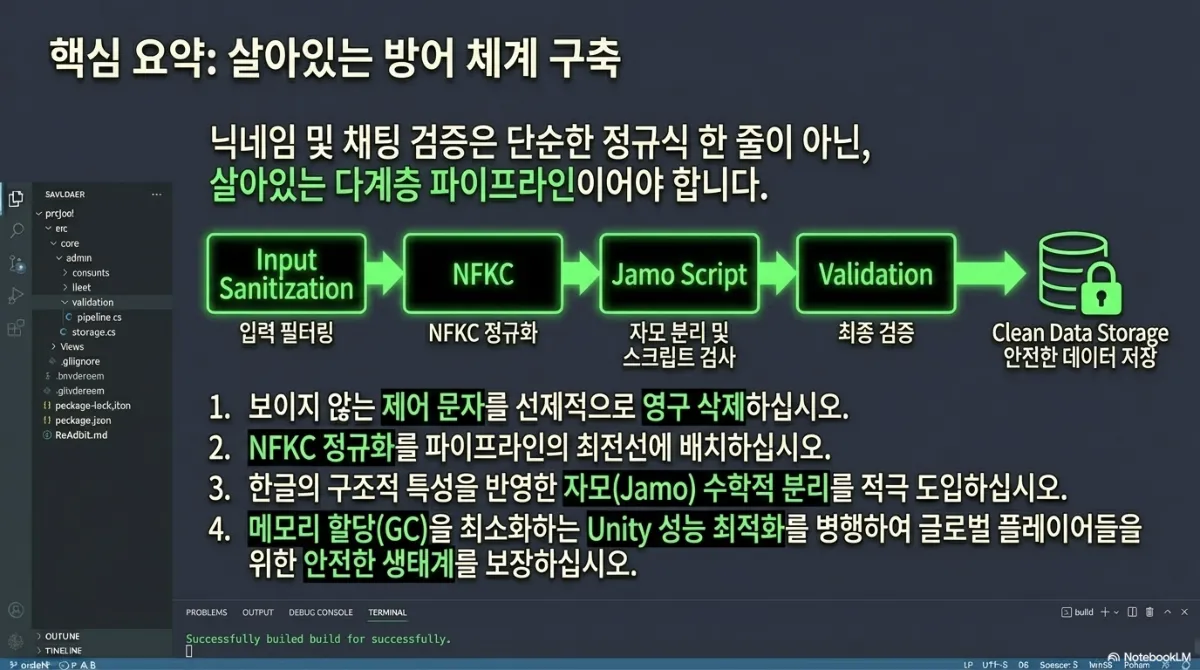
핵심 요약 살아있는 방어 체계 구축 도식. 닉네임 및 채팅 검증은 단순한 정규식 한 줄이 아닌 살아있는 다계층 파이프라인이어야 한다는 설명. Input Sanitization → NFKC → Jamo Script → Validation → Clean Data Storage로 이어지는 흐름. 1 보이지 않는 제어 문자를 선제적으로 영구 삭제, 2 NFKC 정규화를 파이프라인의 최전선에 배치, 3 한글의 구조적 특성을 반영한 자모 수학적 분리를 적극 도입, 4 메모리 할당을 최소화하는 Unity 성능 최적화를 병행하여 안전한 생태계를 보장

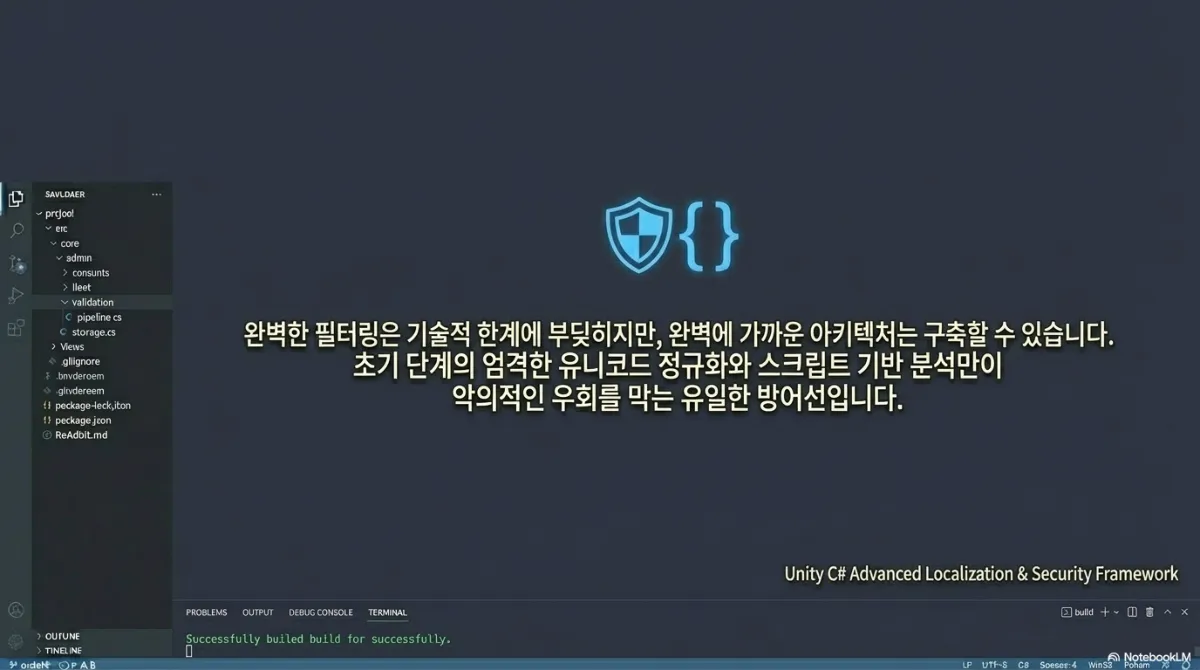
마무리 슬라이드. 완벽한 필터링은 기술적 한계에 부딪히지만 완벽에 가까운 아키텍처는 구축할 수 있다는 문구. 초기 단계의 엄격한 유니코드 정규화와 스크립트 기반 분석만이 악의적인 우회를 막는 유일한 방어선이라는 결론

자주 묻는 질문

정규식 블랙리스트만으로는 정말 부족한가요? 욕설 변형을 일일이 등록하는 방식은 새로운 변형이 나올 때마다 쫓아가야 해서 유지비가 계속 늘어납니다. 자모 분리와 정규화를 먼저 거치면 애초에 변형의 여지가 줄어들어, 블랙리스트가 훨씬 짧아지고 오래갑니다. 블랙리스트를 없애라는 뜻이 아니라 마지막 단계로 축소하라는 뜻입니다.

모든 검증을 서버에서 하면 사용자 경험이 나빠지지 않나요? 클라이언트에서 1차로 걸러 즉시 피드백을 주고, 서버에서 최종 확정하는 이중 구조가 정답입니다. 사용자는 입력 중 바로 안내를 받고, 실제 저장은 서버가 재검증한 값으로만 이루어집니다. 클라이언트 검증 결과를 그대로 믿고 저장하면 우회가 뚫립니다.

한글 자모 분리를 도입하면 성능에 얼마나 영향이 있나요? 자모 분리 자체는 유니코드 값에 뺄셈과 나머지 연산만 쓰는 가벼운 계산입니다. 문제가 되는 것은 매 프레임 반복 호출하는 경우입니다. 채팅처럼 입력이 잦은 곳은 결과를 캐싱하고, 정규식은 컴파일된 상태로 재사용하는 것으로 대부분 해결됩니다.

욕설의 은어나 발음 유사성까지 잡으려면 AI가 꼭 필요한가요? 구조적 우회(동형 문자, 자모 쪼개기, 제어 문자)는 알고리즘으로 대부분 막을 수 있지만, 문맥적 은어는 결국 사람이나 모델의 판단이 필요합니다. 다만 모든 텍스트를 AI로 보내면 비용이 커지므로, 알고리즘 필터를 통과한 것 중 신고가 들어온 것만 AI로 재검토하는 방식이 현실적입니다.

저희가 이 이야기를 하는 이유

에버스톤은 여러 언어권에 게임을 서비스하면서 닉네임·채팅 필터를 직접 운영합니다. 정규식 하나로 막아 두었던 초기 버전이 얼마 지나지 않아 우회당하는 것을 겪었고, 그 뒤로 정규화와 자모 분리를 기본 단계로 두게 되었습니다. 언어별로 우회 방식이 다르다는 것도 실제로 신고 사례를 보며 배운 부분입니다.

인용한 기법과 코드 예시는 원 자료 기준입니다. 실제 적용 전에는 서비스 환경에 맞는 별도 검증이 필요합니다.

다른 글