(주)에버스톤 · 부산 해운대 BCC 613호

AI 코딩 도구는 자동완성으로 고르지 않는다 — 컨텍스트, 거버넌스, 파일럿으로 고르는 법

AI 코딩 도구의 차이는 이제 자동완성이 아니라 여러 파일을 고치는 자율 실행력에서 납니다. Cursor, Copilot, Windsurf, Claude Code, Tabnine을 컨텍스트·보안·비용으로 비교하고 도입 전 3주 파일럿으로 검증하는 방법까지 정리했습니다.
에버스톤14분 분량AI · 개발AI 도입 컨설팅
AI 코딩 도구는 자동완성으로 고르지 않는다 — 컨텍스트, 거버넌스, 파일럿으로 고르는 법 대표 이미지

AI 코딩 도구를 고를 때 "어느 쪽이 자동완성을 더 잘하나"를 묻는 단계는 지났습니다. 이 자료는 차이가 여러 파일에 걸친 구조 변경과 자율 실행력에서 벌어진다고 보고, 도구를 컨텍스트 크기·보안·비용 기준으로 나눈 뒤 조직 목표에 맞춰 고르고 3주 파일럿으로 검증하라고 권합니다.

이 문서는 NotebookLM(노트북 LM)으로 자료를 조사해 만든 문서입니다.

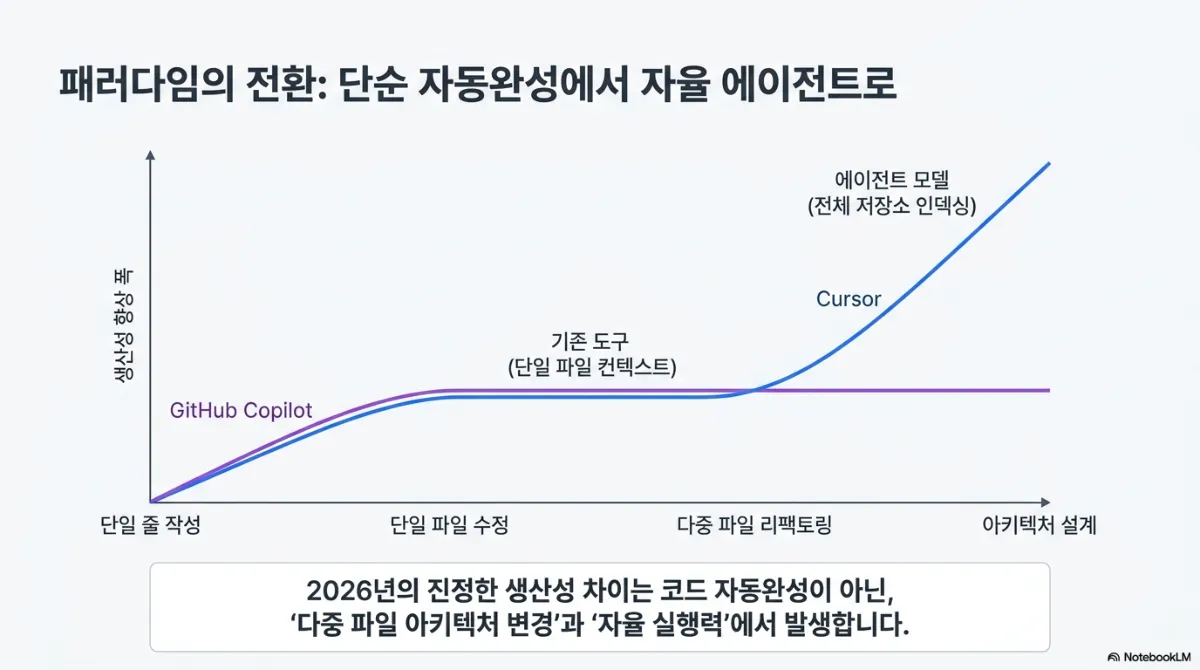
  • 생산성 차이는 한 줄 자동완성이 아니라 다중 파일 리팩토링과 자율 실행에서 생깁니다
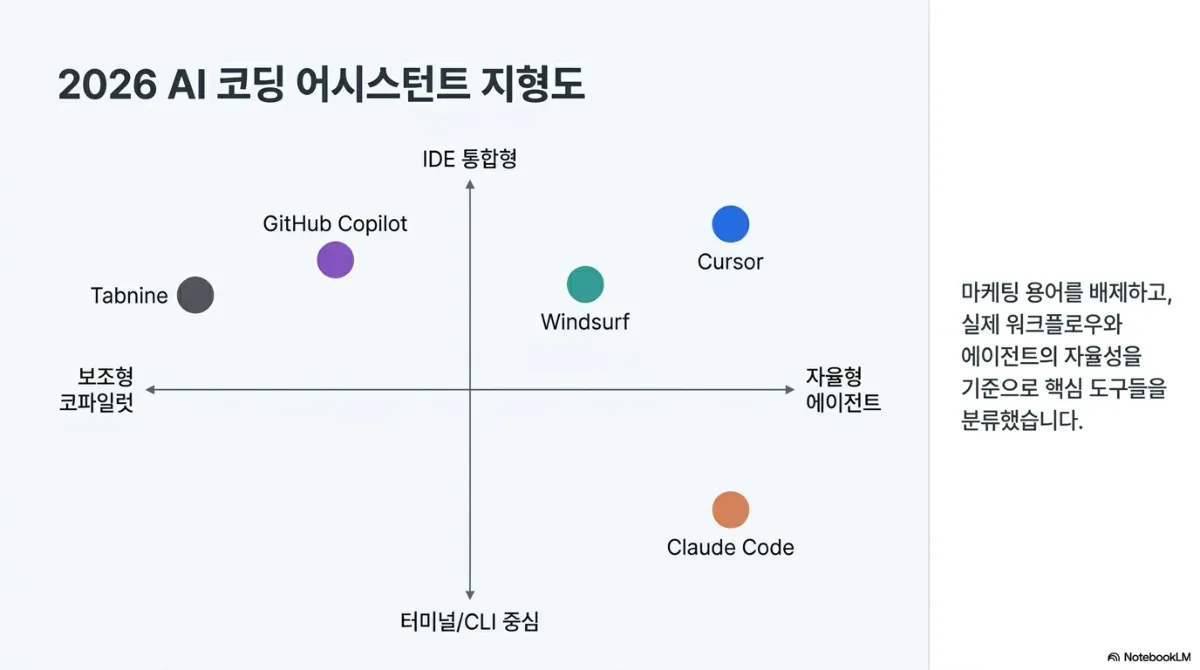
  • 도구는 보조형 ↔ 자율형, IDE 통합형 ↔ 터미널 중심 두 축으로 나눠 볼 수 있습니다
  • AI가 한 번에 볼 수 있는 컨텍스트 크기가 대규모 리팩토링의 성패를 가릅니다
  • 망분리·법적 보증 같은 거버넌스 요건이 성능보다 먼저 후보를 거릅니다
  • 도입 판단은 감상이 아니라 PR 병합 시간 같은 지표로, 최소 4~8주 뒤에 합니다

자동완성에서 에이전트로
패러다임의 전환: 단순 자동완성에서 자율 에이전트로 그래프. 가로축은 단일 줄 작성 → 단일 파일 수정 → 다중 파일 리팩토링 → 아키텍처 설계, 세로축은 생산성 향상 폭. GitHub Copilot 등 기존 도구(단일 파일 컨텍스트)는 단일 파일 수정 이후 수평으로 정체하고, Cursor 등 에이전트 모델(전체 저장소 인덱싱)은 다중 파일 리팩토링 구간부터 가파르게 상승. 아래 문구는 2026년의 진정한 생산성 차이는 코드 자동완성이 아닌 다중 파일 아키텍처 변경과 자율 실행력에서 발생한다는 것

2026 AI 코딩 어시스턴트 지형도 사분면. 가로축은 보조형 코파일럿 ↔ 자율형 에이전트, 세로축은 IDE 통합형 ↔ 터미널/CLI 중심. Tabnine과 GitHub Copilot은 IDE 통합·보조형 쪽, Windsurf는 중앙 약간 오른쪽 위, Cursor는 IDE 통합·자율형 오른쪽 위, Claude Code는 터미널 중심·자율형 오른쪽 아래에 위치. 마케팅 용어를 배제하고 실제 워크플로와 에이전트의 자율성을 기준으로 핵심 도구들을 분류했다는 설명

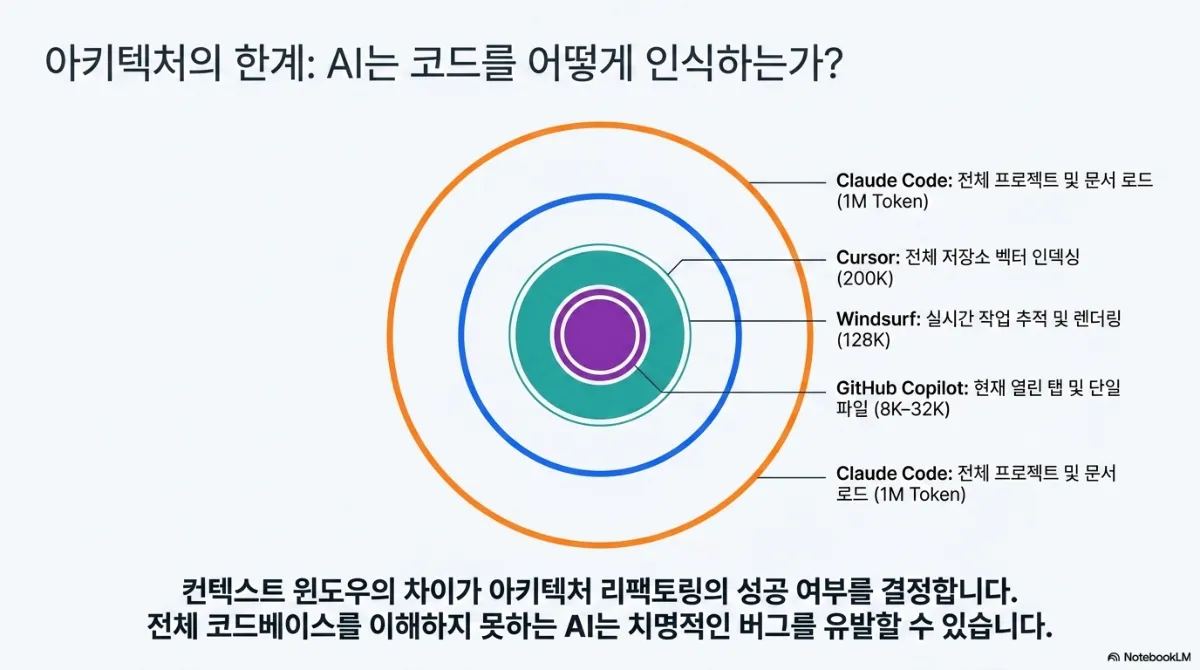
아키텍처의 한계: AI는 코드를 어떻게 인식하는가 동심원 도식. 가장 안쪽 GitHub Copilot은 현재 열린 탭 및 단일 파일(8K~32K), Windsurf는 실시간 작업 추적 및 렌더링(128K), Cursor는 전체 저장소 벡터 인덱싱(200K), 가장 바깥 Claude Code는 전체 프로젝트 및 문서 로드(1M Token). 원본에는 Claude Code 설명이 두 번 표기됨. 아래 문구는 컨텍스트 윈도우의 차이가 아키텍처 리팩토링의 성공 여부를 결정하며 전체 코드베이스를 이해하지 못하는 AI는 치명적인 버그를 유발할 수 있다는 것

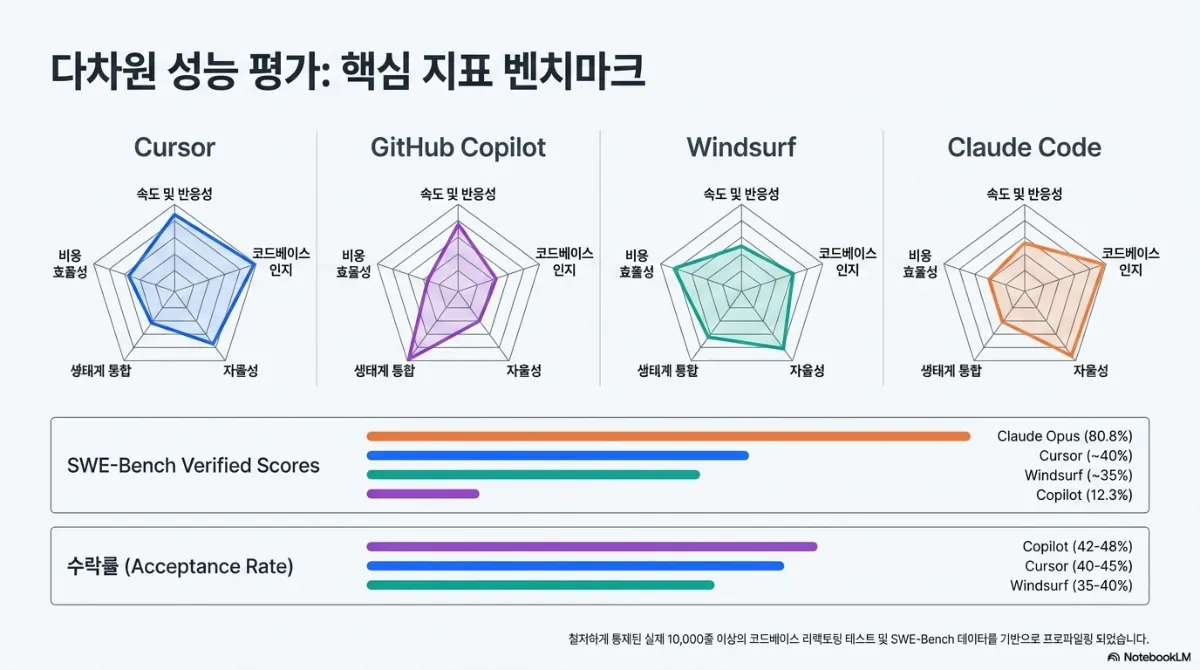
다차원 성능 평가: 핵심 지표 벤치마크. Cursor, GitHub Copilot, Windsurf, Claude Code 네 도구의 오각형 레이더 차트(속도 및 반응성, 코드베이스 인지, 자율성, 생태계 통합, 비용 효율성). Cursor는 속도·코드베이스 인지·자율성이 높고, Copilot은 생태계 통합이 두드러지며, Windsurf는 자율성과 비용 효율성이 고르고, Claude Code는 코드베이스 인지와 자율성이 높음. SWE-Bench Verified 점수는 Claude Opus 80.8%, Cursor 약 40%, Windsurf 약 35%, Copilot 12.3%. 수락률(Acceptance Rate)은 Copilot 4248%, Cursor 4045%, Windsurf 35~40%. 철저하게 통제된 실제 10,000줄 이상의 코드베이스 리팩토링 테스트 및 SWE-Bench 데이터를 기반으로 프로파일링했다는 주석

컨텍스트 크기가 중요한 이유는 단순합니다. 함수 하나를 고칠 때 그 함수를 부르는 다른 파일을 못 보면, 고친 코드는 맞아도 프로젝트 전체는 깨질 수 있습니다. 다만 벤치마크 수치는 자료 기준이며, 모델 점수와 제품 점수가 한 막대에 섞여 있어 직접 비교하기에는 조건이 다릅니다. 순위보다 **"우리 작업이 한 파일 안에서 끝나는가, 여러 파일을 건드리는가"**를 먼저 따져 보는 편이 실용적입니다.

도구별 성격
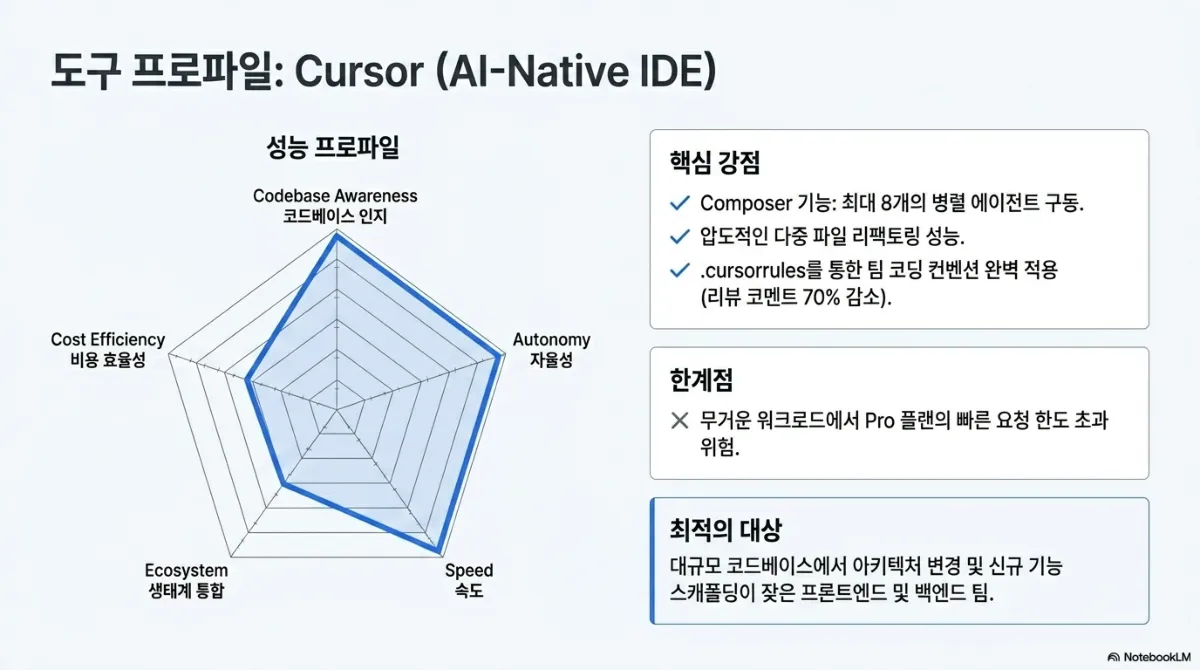
도구 프로파일: Cursor(AI-Native IDE). 레이더 차트는 코드베이스 인지·자율성·속도가 높고 비용 효율성·생태계 통합은 중간 이하. 핵심 강점은 Composer 기능으로 최대 8개의 병렬 에이전트 구동, 압도적인 다중 파일 리팩토링 성능, .cursorrules를 통한 팀 코딩 컨벤션 적용(리뷰 코멘트 70% 감소). 한계점은 무거운 워크로드에서 Pro 플랜의 빠른 요청 한도 초과 위험. 최적의 대상은 대규모 코드베이스에서 아키텍처 변경 및 신규 기능 스캐폴딩이 잦은 프런트엔드 및 백엔드 팀

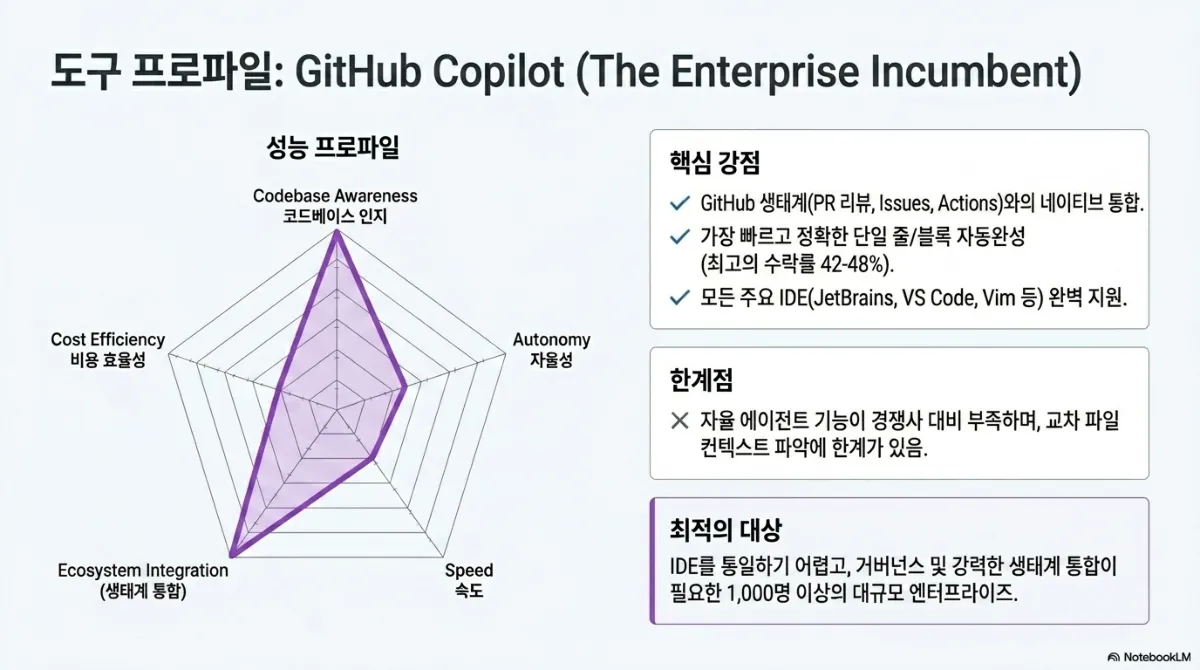
도구 프로파일: GitHub Copilot(The Enterprise Incumbent). 레이더 차트는 생태계 통합과 코드베이스 인지 축이 길고 자율성·속도·비용 효율성은 낮은 편. 핵심 강점은 GitHub 생태계(PR 리뷰, Issues, Actions)와의 네이티브 통합, 가장 빠르고 정확한 단일 줄/블록 자동완성(수락률 42~48%), 모든 주요 IDE(JetBrains, VS Code, Vim 등) 지원. 한계점은 자율 에이전트 기능이 경쟁사 대비 부족하며 교차 파일 컨텍스트 파악에 한계. 최적의 대상은 IDE를 통일하기 어렵고 거버넌스 및 강력한 생태계 통합이 필요한 1,000명 이상의 대규모 엔터프라이즈

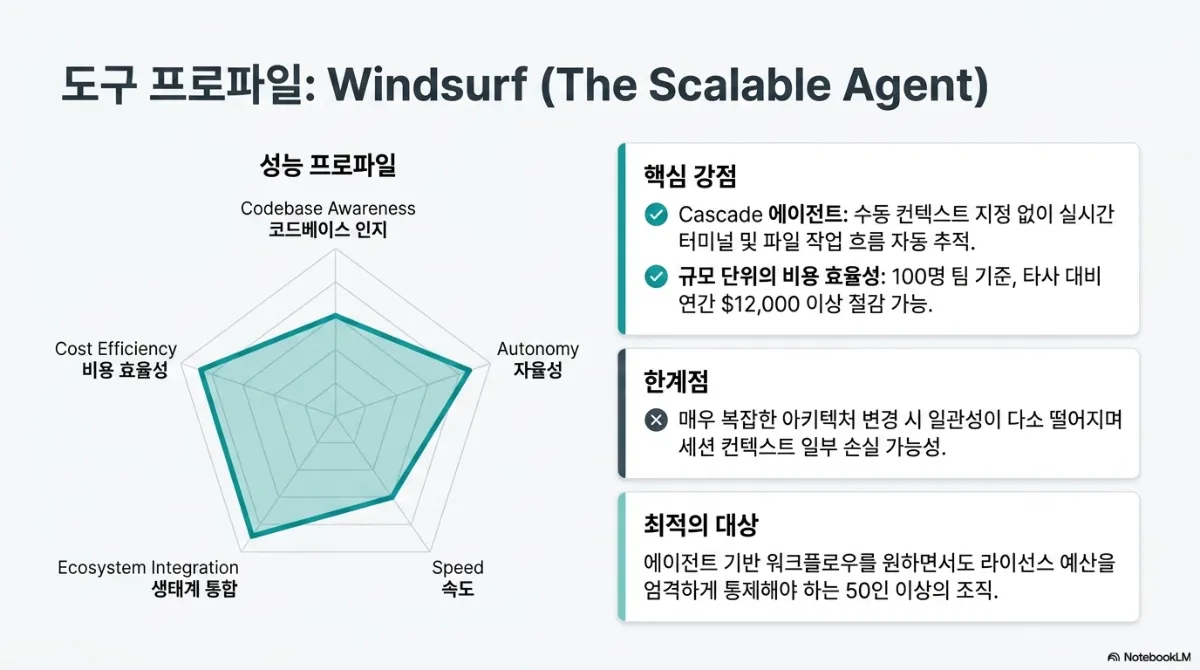
도구 프로파일: Windsurf(The Scalable Agent). 레이더 차트는 비용 효율성·자율성·생태계 통합이 고르게 높은 편. 핵심 강점은 Cascade 에이전트로 수동 컨텍스트 지정 없이 실시간 터미널 및 파일 작업 흐름 자동 추적, 규모 단위의 비용 효율성으로 100명 팀 기준 타사 대비 연간 12,000달러 이상 절감 가능. 한계점은 매우 복잡한 아키텍처 변경 시 일관성이 다소 떨어지며 세션 컨텍스트 일부 손실 가능성. 최적의 대상은 에이전트 기반 워크플로를 원하면서도 라이선스 예산을 엄격하게 통제해야 하는 50인 이상의 조직

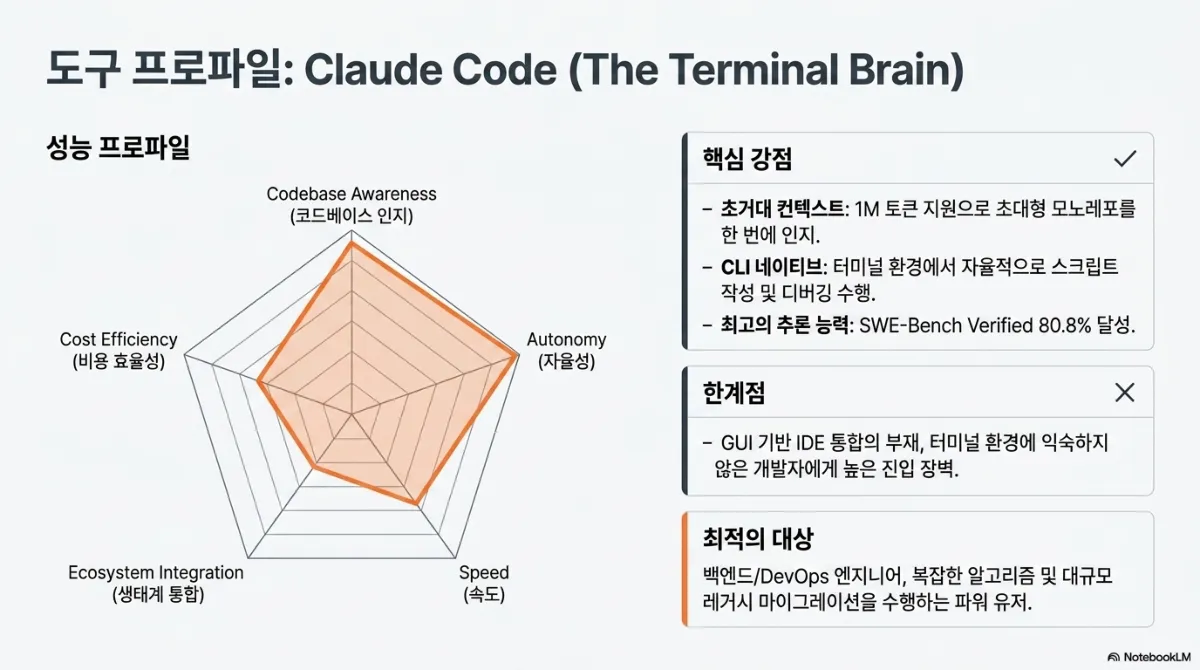
도구 프로파일: Claude Code(The Terminal Brain). 레이더 차트는 코드베이스 인지와 자율성이 높고 생태계 통합은 낮은 편. 핵심 강점은 초거대 컨텍스트로 1M 토큰 지원을 통해 초대형 모노레포를 한 번에 인지, CLI 네이티브로 터미널 환경에서 자율적으로 스크립트 작성 및 디버깅 수행, 추론 능력으로 SWE-Bench Verified 80.8% 달성. 한계점은 GUI 기반 IDE 통합의 부재, 터미널 환경에 익숙하지 않은 개발자에게 높은 진입 장벽. 최적의 대상은 백엔드/DevOps 엔지니어, 복잡한 알고리즘 및 대규모 레거시 마이그레이션을 수행하는 파워 유저

네 도구의 "최적의 대상" 칸만 모아 읽어도 선택 기준이 보입니다. 팀 규모, IDE 통일 여부, 터미널 친숙도, 예산 통제 강도가 도구를 가릅니다. 성능이 가장 높은 도구가 아니라, 팀이 매일 쓰는 방식에 가장 덜 마찰을 주는 도구가 결국 오래 쓰입니다.

보안·비용·종합 비교
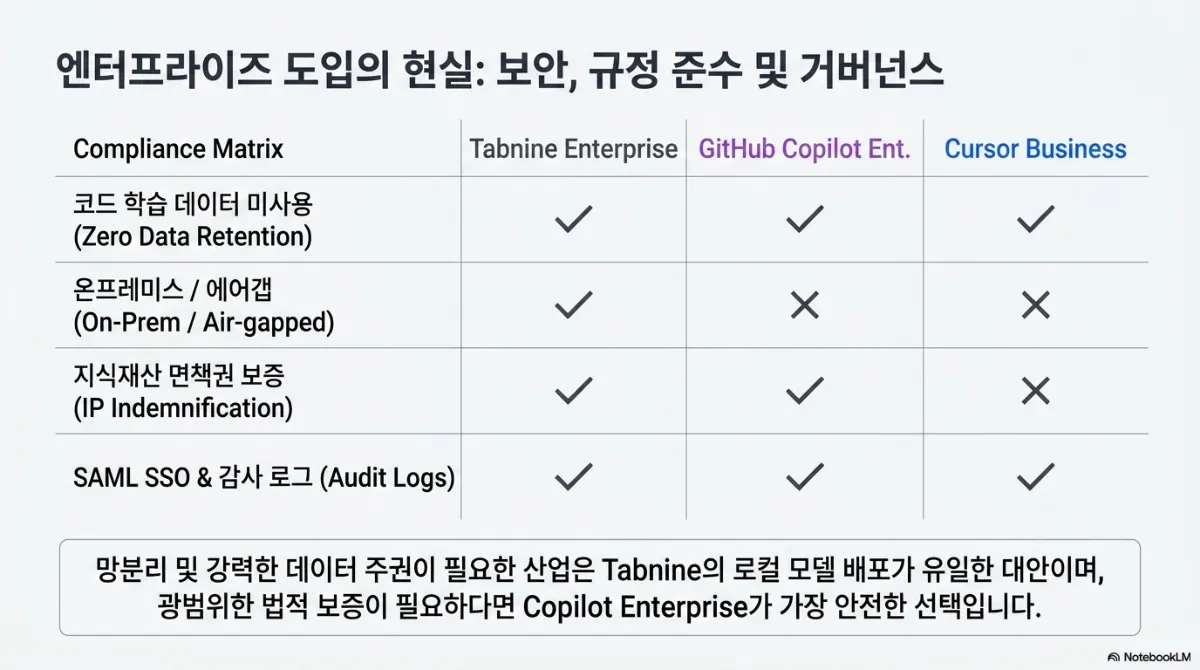
엔터프라이즈 도입의 현실: 보안, 규정 준수 및 거버넌스 컴플라이언스 매트릭스. Tabnine Enterprise는 코드 학습 데이터 미사용(Zero Data Retention), 온프레미스/에어갭, 지식재산 면책권 보증(IP Indemnification), SAML SSO 및 감사 로그 모두 지원. GitHub Copilot Enterprise는 온프레미스/에어갭만 미지원, 나머지 지원. Cursor Business는 코드 학습 데이터 미사용과 SAML SSO·감사 로그는 지원, 온프레미스/에어갭과 지식재산 면책권 보증은 미지원. 아래 문구는 망분리 및 강력한 데이터 주권이 필요한 산업은 Tabnine의 로컬 모델 배포가 유일한 대안이며, 광범위한 법적 보증이 필요하다면 Copilot Enterprise가 가장 안전한 선택이라는 것

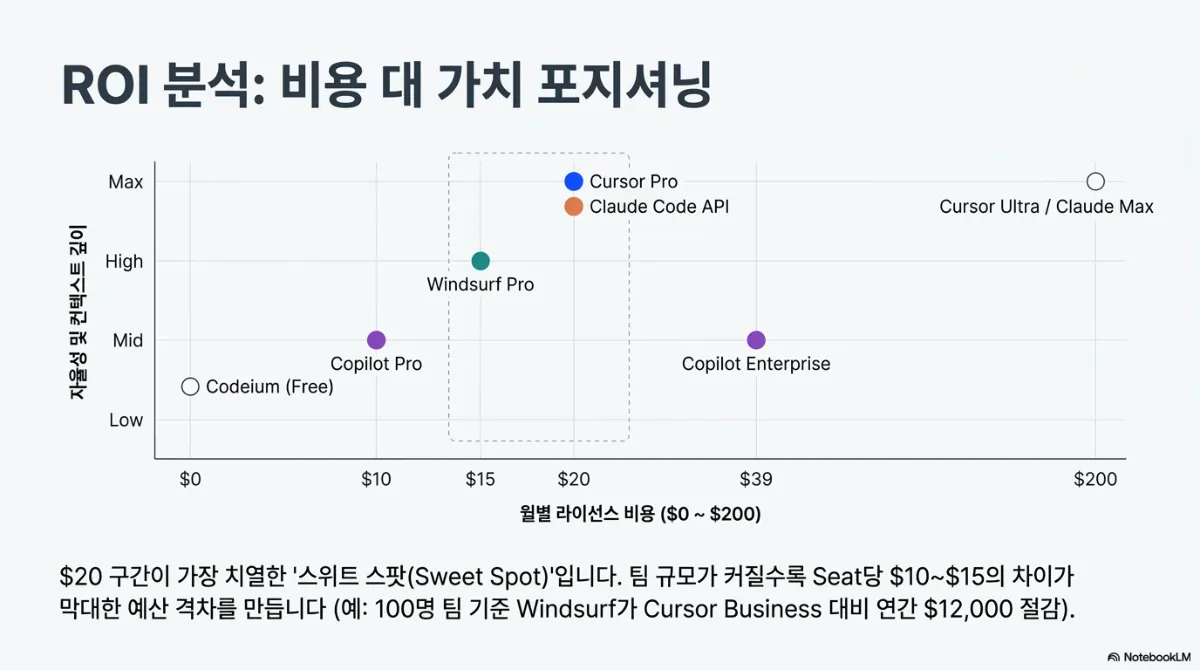
ROI 분석: 비용 대 가치 포지셔닝 산점도. 가로축은 월별 라이선스 비용(0200달러), 세로축은 자율성 및 컨텍스트 깊이(LowMax). Codeium(Free)은 0달러·Low, Copilot Pro는 10달러·Mid, Windsurf Pro는 15달러·High, Cursor Pro와 Claude Code API는 20달러·Max, Copilot Enterprise는 39달러·Mid, Cursor Ultra / Claude Max는 200달러·Max. 1520달러 구간이 점선 박스로 강조됨. 아래 설명은 20달러 구간이 가장 치열한 스위트 스폿이며 팀 규모가 커질수록 Seat당 1015달러의 차이가 큰 예산 격차를 만든다는 것(예: 100명 팀 기준 Windsurf가 Cursor Business 대비 연간 12,000달러 절감)

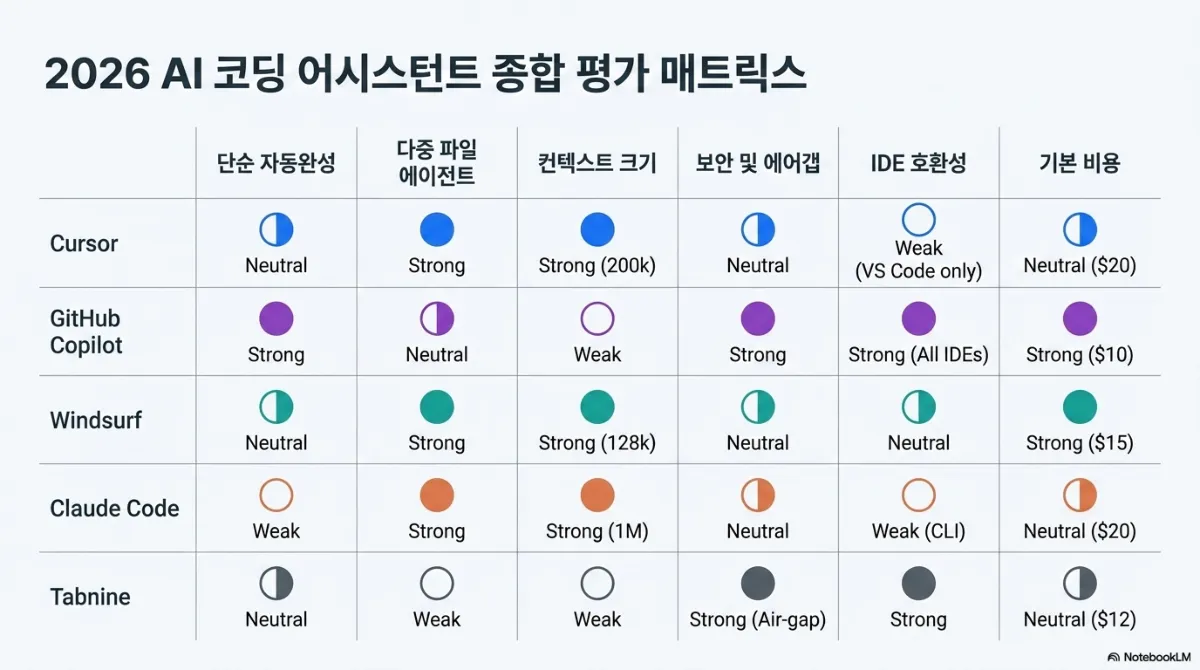
2026 AI 코딩 어시스턴트 종합 평가 매트릭스. 평가 항목은 단순 자동완성, 다중 파일 에이전트, 컨텍스트 크기, 보안 및 에어갭, IDE 호환성, 기본 비용. Cursor는 Neutral, Strong, Strong(200k), Neutral, Weak(VS Code only), Neutral(20달러). GitHub Copilot은 Strong, Neutral, Weak, Strong, Strong(All IDEs), Strong(10달러). Windsurf는 Neutral, Strong, Strong(128k), Neutral, Neutral, Strong(15달러). Claude Code는 Weak, Strong, Strong(1M), Neutral, Weak(CLI), Neutral(20달러). Tabnine은 Neutral, Weak, Weak, Strong(Air-gap), Strong, Neutral(12달러)

보안표는 후보를 먼저 거르는 체로 쓰는 것이 맞습니다. 사내 코드를 외부로 보낼 수 없는 조직이라면 성능 비교는 의미가 없습니다. 비용은 한 사람 단가로 보면 차이가 작아 보이지만, 인원이 늘면 연 단위로 커집니다. 가격과 기능은 자주 바뀌므로 자료의 표는 비교 틀로만 쓰고, 실제 값은 도입 시점에 각 서비스 공지로 다시 확인해야 합니다.

고르고, 검증하는 순서
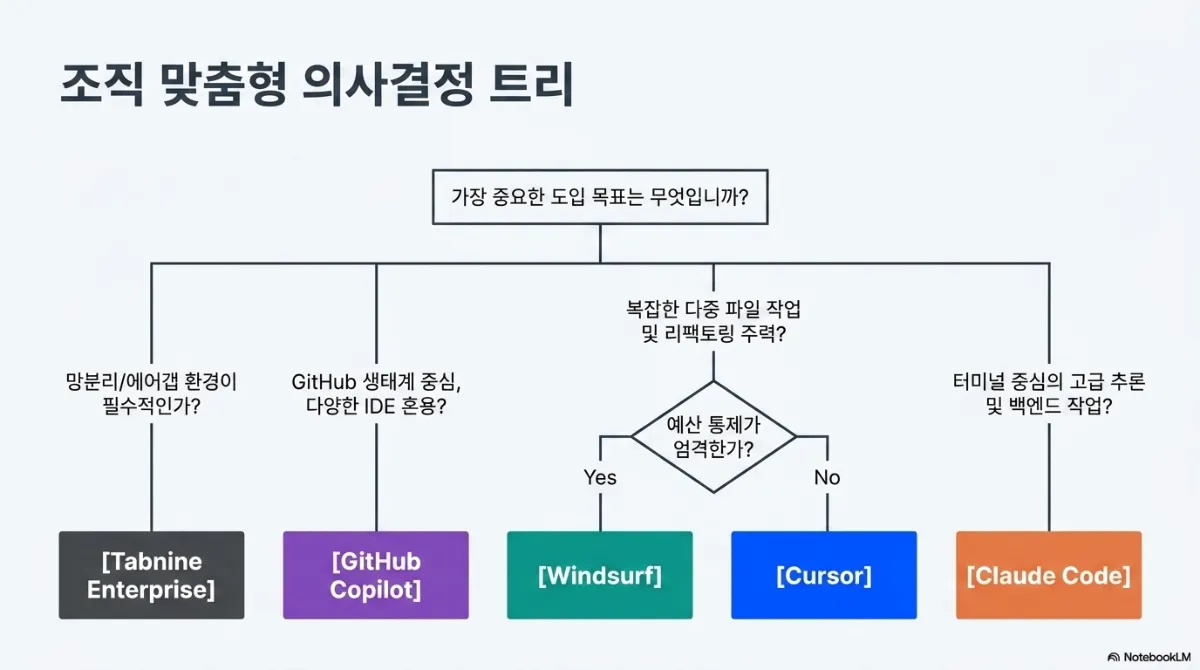
조직 맞춤형 의사결정 트리. 가장 중요한 도입 목표는 무엇인가라는 질문에서 네 갈래로 분기. 망분리/에어갭 환경이 필수적인가 → Tabnine Enterprise. GitHub 생태계 중심, 다양한 IDE 혼용 → GitHub Copilot. 복잡한 다중 파일 작업 및 리팩토링 주력 → 예산 통제가 엄격한가, Yes면 Windsurf, No면 Cursor. 터미널 중심의 고급 추론 및 백엔드 작업 → Claude Code

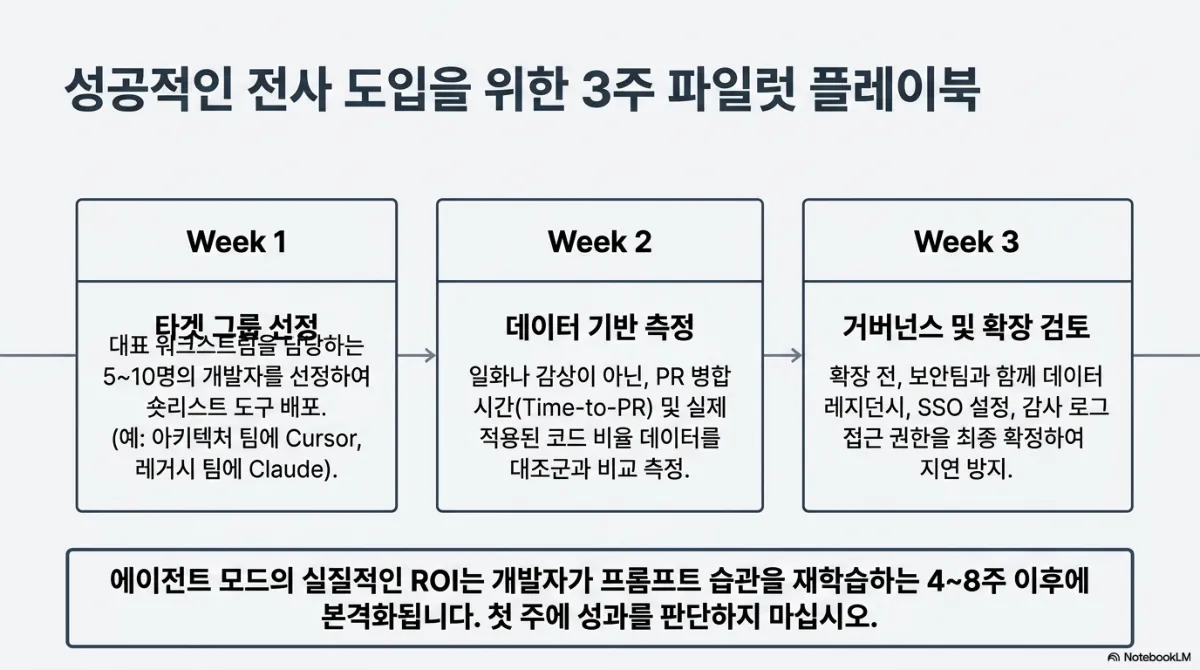
성공적인 전사 도입을 위한 3주 파일럿 플레이북. Week 1 타깃 그룹 선정 — 대표 워크스트림을 담당하는 510명의 개발자를 선정하여 숏리스트 도구 배포(예: 아키텍처 팀에 Cursor, 레거시 팀에 Claude). Week 2 데이터 기반 측정 — 일화나 감상이 아닌 PR 병합 시간(Time-to-PR) 및 실제 적용된 코드 비율 데이터를 대조군과 비교 측정. Week 3 거버넌스 및 확장 검토 — 확장 전 보안팀과 함께 데이터 레지던시, SSO 설정, 감사 로그 접근 권한을 최종 확정하여 지연 방지. 아래 문구는 에이전트 모드의 실질적인 ROI는 개발자가 프롬프트 습관을 재학습하는 48주 이후에 본격화되므로 첫 주에 성과를 판단하지 말라는 것

파일럿에서 가장 흔한 실수는 "써 보니 좋더라"로 결론 내는 것입니다. 대조군을 두고 PR 병합 시간과 실제 반영된 코드 비율을 재야 확장 여부를 판단할 수 있습니다. 또 하나는 조급함입니다. 에이전트형 도구는 작업을 맡기는 방식 자체가 바뀌기 때문에, 첫 주에는 오히려 느려 보일 수 있다는 점을 미리 공유해 두는 것이 좋습니다.

자주 묻는 질문

한 팀에 도구 하나만 정해야 하나요? 꼭 그렇지 않습니다. 자료도 아키텍처 팀과 레거시 팀에 서로 다른 도구를 배포해 비교하는 파일럿을 예로 듭니다.

컨텍스트가 크면 무조건 좋은가요? 대규모 리팩토링에는 유리하지만, 단일 파일 자동완성 위주라면 체감 차이가 작습니다. 작업 유형을 먼저 확인해야 합니다.

사내 코드가 외부로 나가는 것이 걱정됩니다. 학습 데이터 미사용, 온프레미스 지원 여부를 먼저 확인하십시오. 자료는 망분리가 필수면 로컬 배포형만 후보로 봅니다.

도입 효과는 언제 판단하나요? 자료는 에이전트 모드의 효과가 4~8주 뒤에 본격화된다고 봅니다. 첫 주 체감보다 PR 병합 시간 추이를 보는 편이 정확합니다.

저희가 이 이야기를 하는 이유

에버스톤은 게임·앱·웹 개발에 AI 코딩 도구를 쓰고 있고, AI 도입 컨설팅도 합니다. 도구 선택 상담에서 가장 먼저 확인하는 것이 성능 순위가 아니라 코드 반출 가능 여부와 팀의 작업 방식이라는 점에서 이 자료의 순서가 현장과 맞다고 봤습니다.

인용한 벤치마크·수락률·가격·절감액은 모두 원 자료 기준이며, 저희가 검증한 값이 아닙니다. 가격과 보안 기능은 각 서비스의 최신 공지를 확인하시기 바랍니다.

다른 글