(주)에버스톤 · 부산 해운대 BCC 613호

교육 행정에 AI를 들일 때 — 효율과 개인정보 사이의 투트랙 전략

교육 행정 AI는 공문 요약과 취합 업무를 줄이지만 학생 데이터 유출과 환각 오류 위험도 함께 들어옵니다. 공개 자료는 클라우드 AI, 민감 데이터는 로컬 AI로 나누는 투트랙 구성과 하드웨어 요건, 교직원 최종 검토 절차까지 안전한 도입 순서를 정리했습니다.
에버스톤13분 분량AI · 개발공공 · 지자체 사업
교육 행정에 AI를 들일 때 — 효율과 개인정보 사이의 투트랙 전략 대표 이미지

학교와 교육청의 행정 업무는 생성형 AI로 줄일 수 있는 일이 많습니다. 그러나 학생 성적과 교원 개인정보를 외부 서버로 보내는 순간 효율보다 큰 위험이 생깁니다. 이 자료의 결론은 공개 자료는 클라우드 AI로, 민감 데이터는 내부망의 로컬 AI로 나눠 처리하는 투트랙 구성입니다.

이 문서는 NotebookLM(노트북 LM)으로 자료를 조사해 만든 문서입니다.

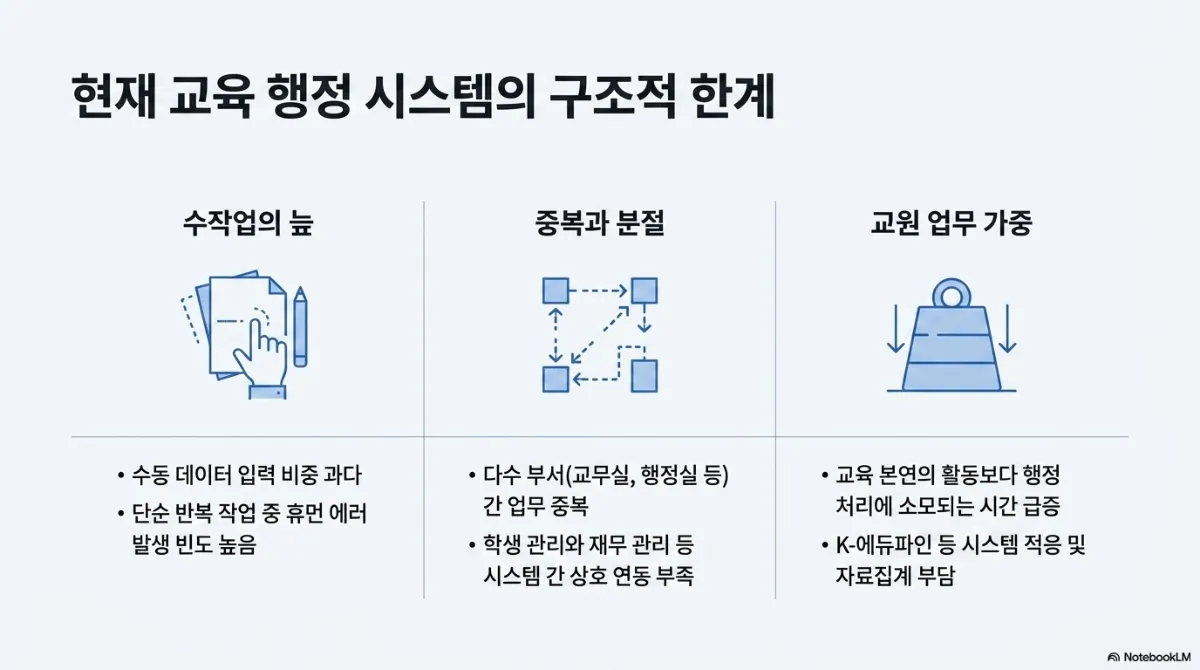
  • 교육 행정은 수작업 입력, 부서 간 중복, 시스템 간 연동 부족으로 교원의 행정 부담이 큽니다
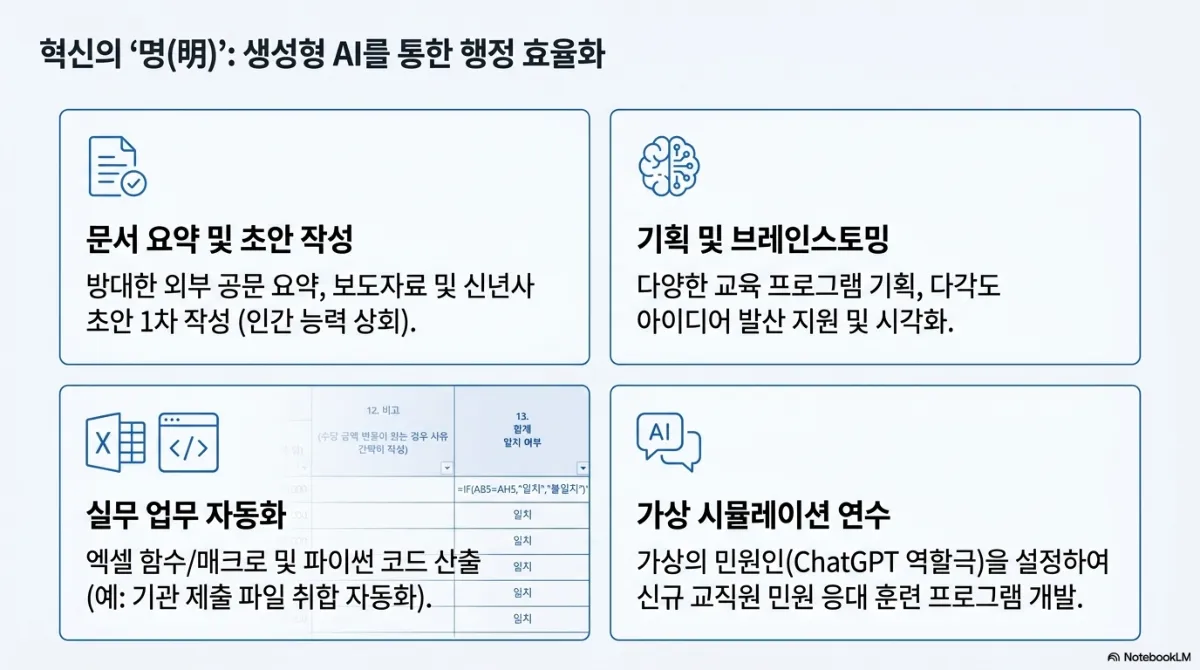
  • 생성형 AI는 공문 요약, 초안 작성, 엑셀·매크로 자동화, 민원 응대 연수에 쓸 수 있습니다
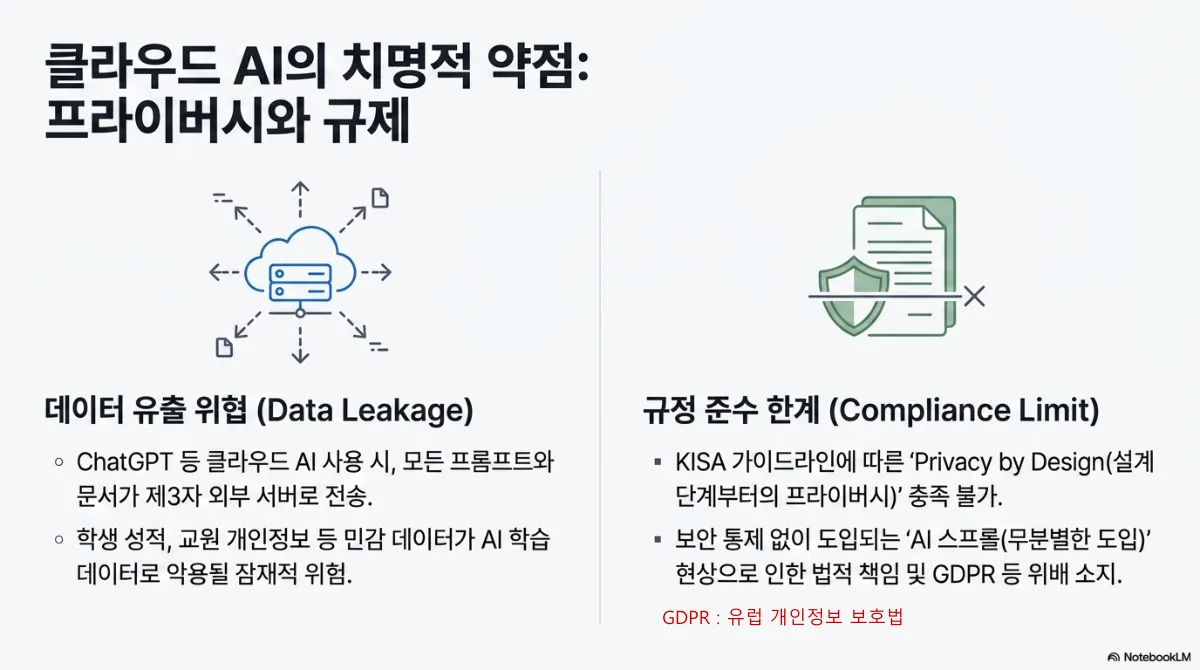
  • 클라우드 AI는 입력한 문서가 외부 서버로 전송되므로 민감 데이터에는 맞지 않습니다
  • 대안은 Ollama 같은 로컬 AI를 망분리 환경에 두고, 칩 수준 보안(TEE)으로 결과물을 검증하는 방식입니다
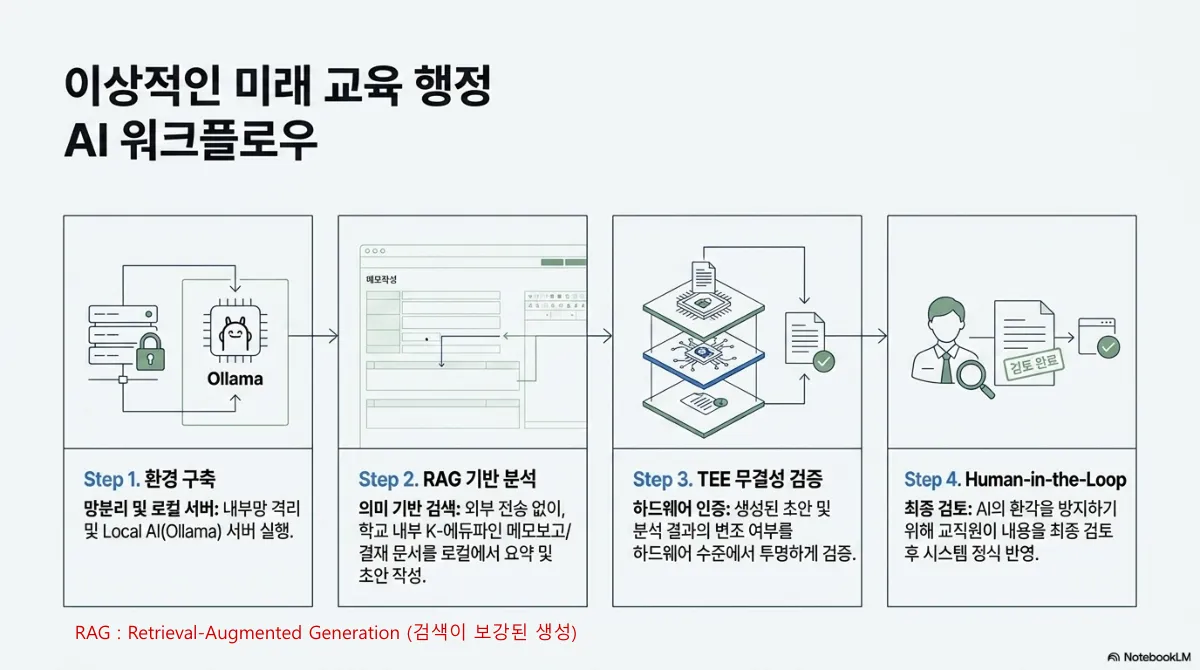
  • 어떤 구성이든 마지막에는 **교직원이 최종 검토하는 단계(HITL)**가 있어야 합니다

미래 교육 행정 시스템과 AI: 양면성 분석 및 도입 전략 표지 슬라이드. 효율성 혁신과 프라이버시 보호의 균형점 찾기라는 부제와 생성형 AI, 로컬 AI, 그리고 시스템 무결성을 중심으로 한 요약 보고서라는 설명. 가운데 옅은 선으로 그린 다면체 결정

기대와 위험을 함께 본다

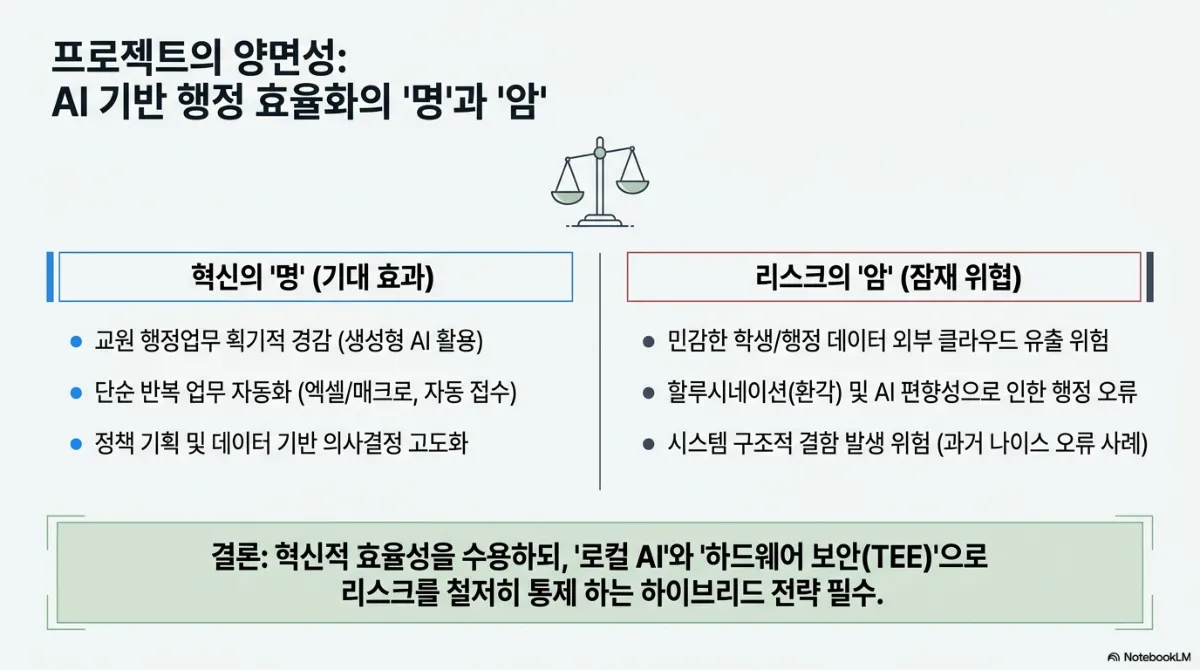
프로젝트의 양면성: AI 기반 행정 효율화의 명과 암 슬라이드. 가운데 저울 아이콘. 혁신의 명(기대 효과) — 교원 행정업무 획기적 경감(생성형 AI 활용), 단순 반복 업무 자동화(엑셀/매크로, 자동 접수), 정책 기획 및 데이터 기반 의사결정 고도화. 리스크의 암(잠재 위협) — 민감한 학생/행정 데이터 외부 클라우드 유출 위험, 할루시네이션(환각) 및 AI 편향성으로 인한 행정 오류, 시스템 구조적 결함 발생 위험(과거 나이스 오류 사례). 결론은 혁신적 효율성을 수용하되 로컬 AI와 하드웨어 보안(TEE)으로 리스크를 철저히 통제하는 하이브리드 전략이 필수라는 것

현재 교육 행정 시스템의 구조적 한계 슬라이드. 수작업의 늪 — 수동 데이터 입력 비중 과다, 단순 반복 작업 중 휴먼 에러 발생 빈도 높음, 문서를 손으로 넘기는 아이콘. 중복과 분절 — 다수 부서(교무실, 행정실 등) 간 업무 중복, 학생 관리와 재무 관리 등 시스템 간 상호 연동 부족, 점선으로 얽힌 사각형 아이콘. 교원 업무 가중 — 교육 본연의 활동보다 행정 처리에 소모되는 시간 급증, K-에듀파인 등 시스템 적응 및 자료집계 부담, 무거운 추 아이콘

혁신의 명(明): 생성형 AI를 통한 행정 효율화 슬라이드. 네 칸 카드. 문서 요약 및 초안 작성 — 방대한 외부 공문 요약, 보도자료 및 신년사 초안 1차 작성(인간 능력 상회). 기획 및 브레인스토밍 — 다양한 교육 프로그램 기획, 다각도 아이디어 발산 지원 및 시각화. 실무 업무 자동화 — 엑셀 함수/매크로 및 파이썬 코드 산출(예: 기관 제출 파일 취합 자동화), 배경에 IF 함수로 합계 일치 여부를 확인하는 엑셀 표. 가상 시뮬레이션 연수 — 가상의 민원인(ChatGPT 역할극)을 설정하여 신규 교직원 민원 응대 훈련 프로그램 개발

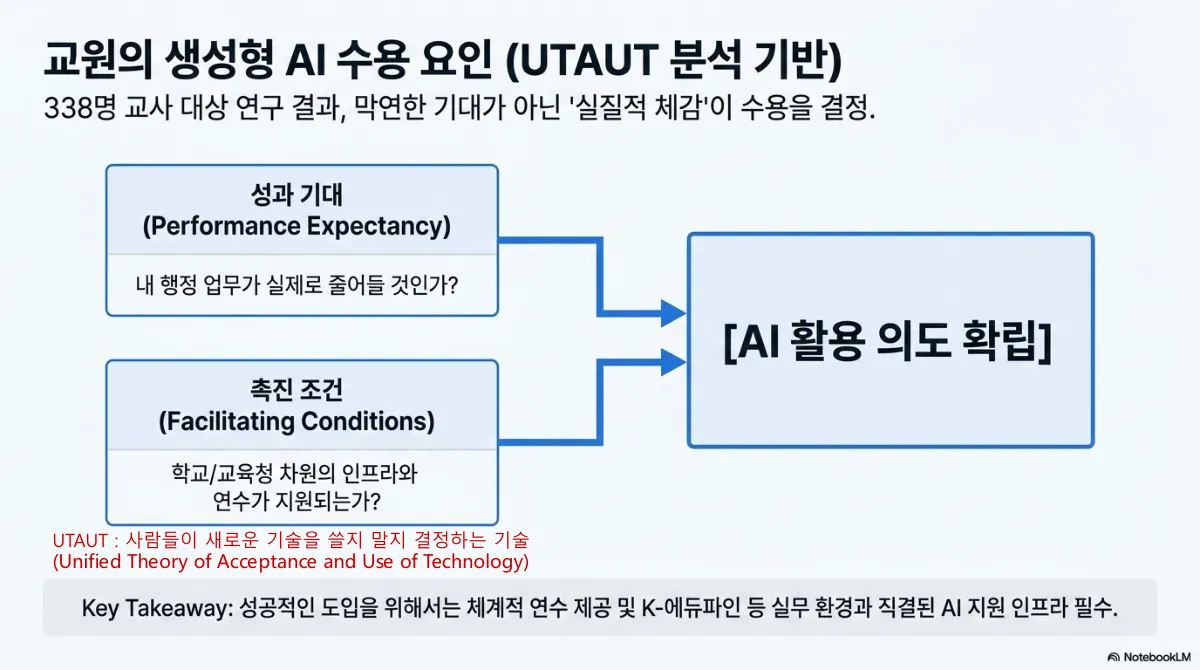
교원의 생성형 AI 수용 요인(UTAUT 분석 기반) 슬라이드. 338명 교사 대상 연구 결과, 막연한 기대가 아닌 실질적 체감이 수용을 결정한다는 설명. 성과 기대(Performance Expectancy) — 내 행정 업무가 실제로 줄어들 것인가, 촉진 조건(Facilitating Conditions) — 학교/교육청 차원의 인프라와 연수가 지원되는가, 두 요인이 화살표로 AI 활용 의도 확립으로 이어지는 도식. UTAUT는 사람들이 새로운 기술을 쓸지 말지 결정하는 기술 수용 이론(Unified Theory of Acceptance and Use of Technology)이라는 주석. Key Takeaway는 성공적인 도입을 위해서는 체계적 연수 제공 및 K-에듀파인 등 실무 환경과 직결된 AI 지원 인프라가 필수라는 것

쓸 곳은 분명합니다. 공문 요약이나 취합용 엑셀 수식처럼 결과를 사람이 바로 확인할 수 있는 일부터 넣는 편이 안전합니다. 수용 요인 분석이 말하는 것도 같습니다. 교원이 AI를 쓰게 만드는 것은 기대가 아니라 내 업무가 실제로 줄었다는 체감이고, 그 체감은 실무 시스템과 맞닿은 연수에서 나옵니다.

클라우드 AI의 한계
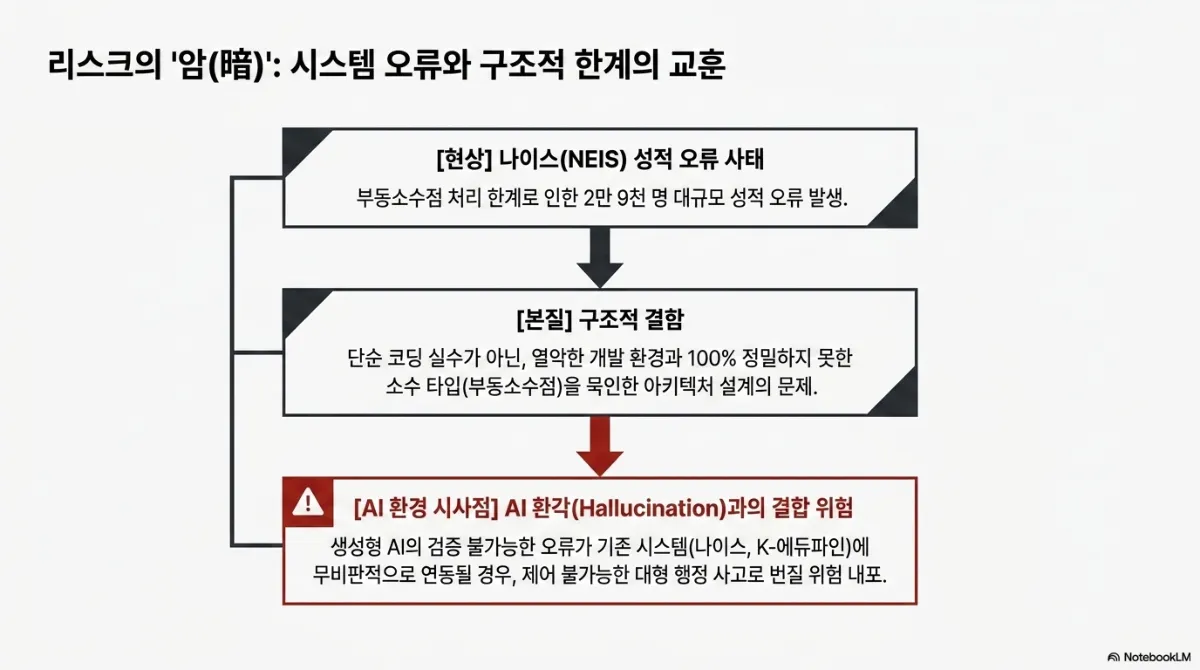
리스크의 암(暗): 시스템 오류와 구조적 한계의 교훈 슬라이드. 위에서 아래로 이어지는 세 단계 상자. 현상 — 나이스(NEIS) 성적 오류 사태, 부동소수점 처리 한계로 인한 2만 9천 명 대규모 성적 오류 발생. 본질 — 구조적 결함, 단순 코딩 실수가 아닌 열악한 개발 환경과 100% 정밀하지 못한 소수 타입(부동소수점)을 묵인한 아키텍처 설계의 문제. AI 환경 시사점(빨간 경고 상자) — AI 환각(Hallucination)과의 결합 위험, 생성형 AI의 검증 불가능한 오류가 기존 시스템(나이스, K-에듀파인)에 무비판적으로 연동될 경우 제어 불가능한 대형 행정 사고로 번질 위험 내포

클라우드 AI의 치명적 약점: 프라이버시와 규제 슬라이드. 데이터 유출 위협(Data Leakage) — ChatGPT 등 클라우드 AI 사용 시 모든 프롬프트와 문서가 제3자 외부 서버로 전송, 학생 성적·교원 개인정보 등 민감 데이터가 AI 학습 데이터로 악용될 잠재적 위험, 사방으로 문서가 퍼지는 클라우드 서버 아이콘. 규정 준수 한계(Compliance Limit) — KISA 가이드라인에 따른 Privacy by Design(설계 단계부터의 프라이버시) 충족 불가, 보안 통제 없이 도입되는 AI 스프롤(무분별한 도입) 현상으로 인한 법적 책임 및 GDPR 등 위배 소지, 방패와 문서에 X 표시 아이콘. GDPR은 유럽 개인정보 보호법이라는 주석

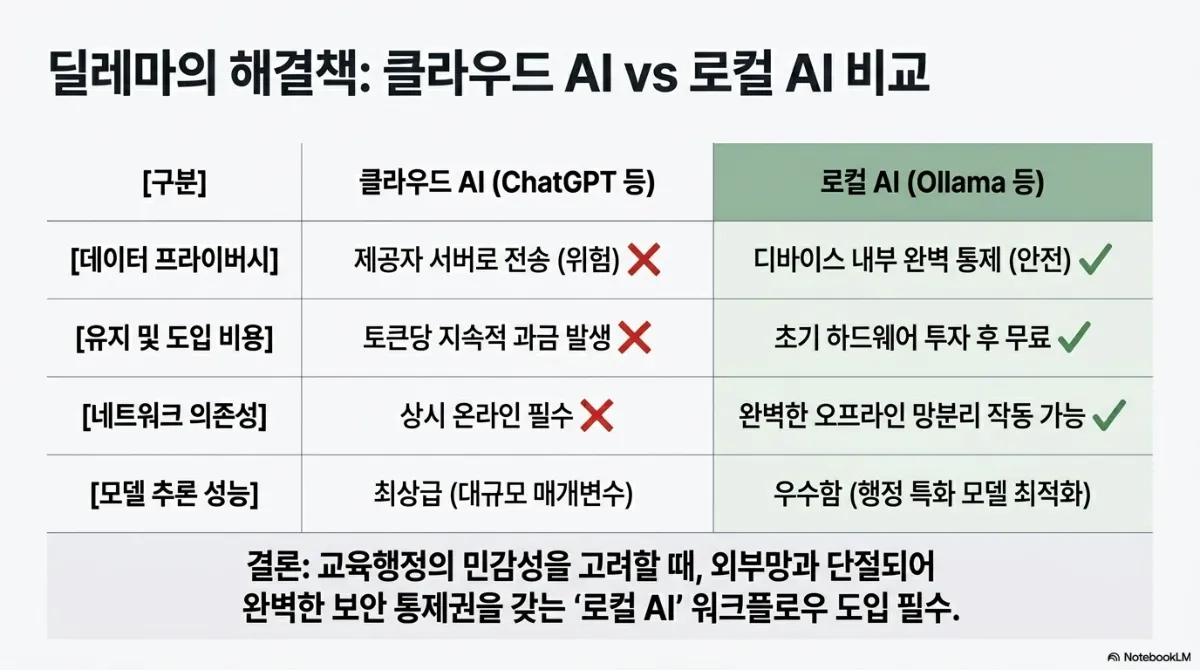
딜레마의 해결책: 클라우드 AI vs 로컬 AI 비교표. 데이터 프라이버시 — 클라우드 AI(ChatGPT 등)는 제공자 서버로 전송(위험), 로컬 AI(Ollama 등)는 디바이스 내부 완벽 통제(안전). 유지 및 도입 비용 — 클라우드는 토큰당 지속적 과금 발생, 로컬은 초기 하드웨어 투자 후 무료. 네트워크 의존성 — 클라우드는 상시 온라인 필수, 로컬은 완벽한 오프라인 망분리 작동 가능. 모델 추론 성능 — 클라우드는 최상급(대규모 매개변수), 로컬은 우수함(행정 특화 모델 최적화). 결론은 교육행정의 민감성을 고려할 때 외부망과 단절되어 완벽한 보안 통제권을 갖는 로컬 AI 워크플로우 도입이 필수라는 것

나이스 사례가 주는 교훈은 AI 이전의 것입니다. 오류는 코드 한 줄이 아니라 정밀도를 확인하지 않은 설계에서 나왔습니다. 여기에 결과를 검증하기 어려운 생성형 AI를 그대로 연결하면 같은 구조의 사고가 더 빨리 퍼질 수 있습니다. 비교표에서 로컬 AI가 성능에서 한발 물러서는 대신 얻는 것은 데이터가 기관 밖으로 나가지 않는다는 확실성입니다. 행정 문서 요약과 초안 작성에는 대형 모델이 아니어도 충분한 경우가 많습니다.

로컬 AI로 구성하는 워크플로우
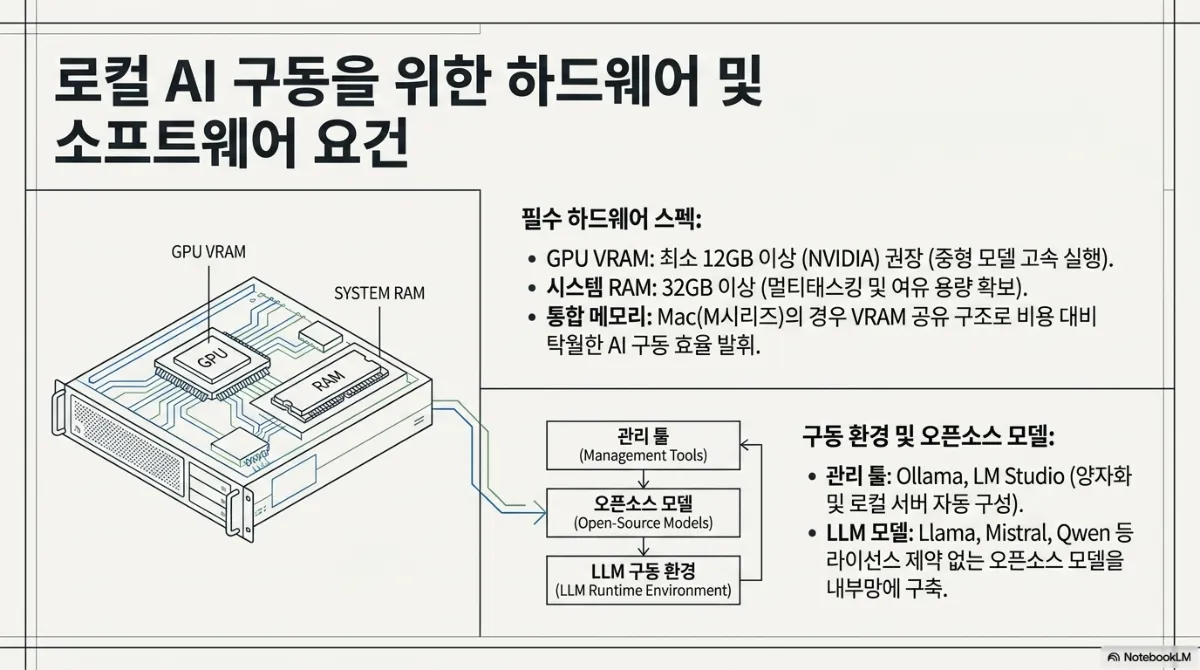
로컬 AI 구동을 위한 하드웨어 및 소프트웨어 요건 슬라이드. GPU VRAM과 SYSTEM RAM을 표시한 서버 도면. 필수 하드웨어 스펙 — GPU VRAM 최소 12GB 이상(NVIDIA) 권장(중형 모델 고속 실행), 시스템 RAM 32GB 이상(멀티태스킹 및 여유 용량 확보), 통합 메모리는 Mac(M시리즈)의 경우 VRAM 공유 구조로 비용 대비 탁월한 AI 구동 효율 발휘. 구동 환경 및 오픈소스 모델 — 관리 툴(Management Tools) → 오픈소스 모델(Open-Source Models) → LLM 구동 환경(LLM Runtime Environment) 순환 도식, 관리 툴은 Ollama·LM Studio(양자화 및 로컬 서버 자동 구성), LLM 모델은 Llama·Mistral·Qwen 등 라이선스 제약 없는 오픈소스 모델을 내부망에 구축

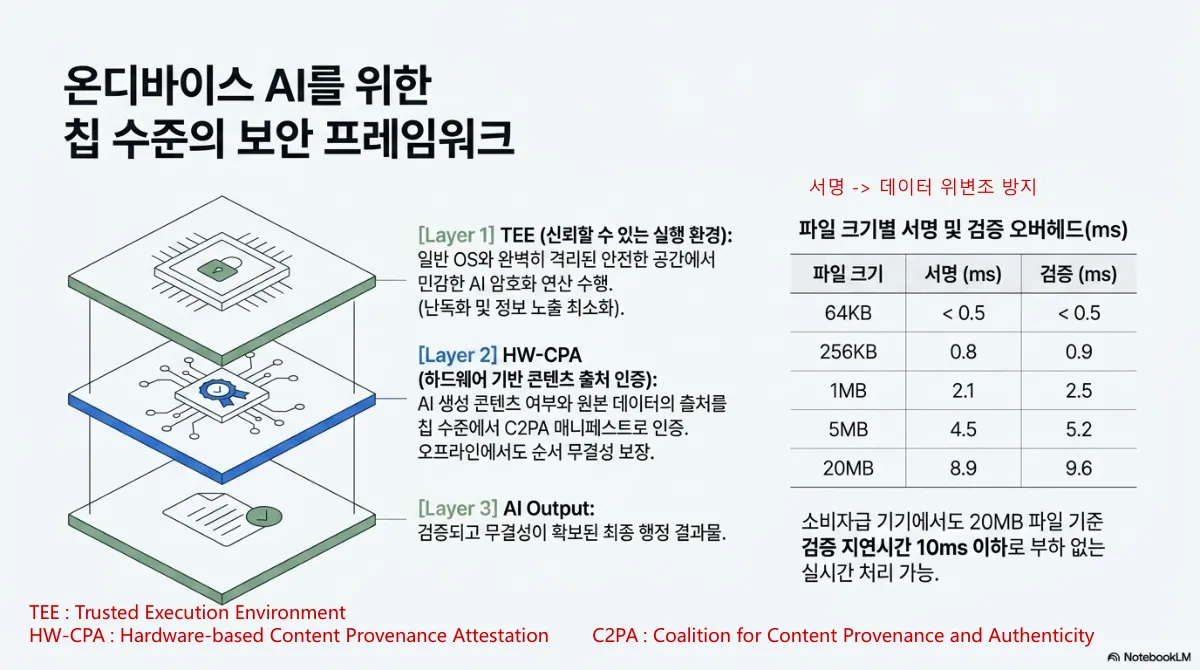
온디바이스 AI를 위한 칩 수준의 보안 프레임워크 슬라이드. 세 층으로 쌓인 칩 도면. Layer 1 TEE(신뢰할 수 있는 실행 환경) — 일반 OS와 완벽히 격리된 안전한 공간에서 민감한 AI 암호화 연산 수행(난독화 및 정보 노출 최소화). Layer 2 HW-CPA(하드웨어 기반 콘텐츠 출처 인증) — AI 생성 콘텐츠 여부와 원본 데이터의 출처를 칩 수준에서 C2PA 매니페스트로 인증, 오프라인에서도 순서 무결성 보장. Layer 3 AI Output — 검증되고 무결성이 확보된 최종 행정 결과물. 오른쪽 파일 크기별 서명 및 검증 오버헤드(ms) 표: 64KB 서명 0.5 미만·검증 0.5 미만, 256KB 0.8·0.9, 1MB 2.1·2.5, 5MB 4.5·5.2, 20MB 8.9·9.6. 서명은 데이터 위변조 방지 목적이며, 소비자급 기기에서도 20MB 파일 기준 검증 지연시간 10ms 이하로 부하 없는 실시간 처리가 가능하다는 설명. TEE는 Trusted Execution Environment, HW-CPA는 Hardware-based Content Provenance Attestation, C2PA는 Coalition for Content Provenance and Authenticity라는 주석

이상적인 미래 교육 행정 AI 워크플로우 네 단계. Step 1 환경 구축 — 망분리 및 로컬 서버, 내부망 격리 및 Local AI(Ollama) 서버 실행. Step 2 RAG 기반 분석 — 의미 기반 검색, 외부 전송 없이 학교 내부 K-에듀파인 메모보고/결재 문서를 로컬에서 요약 및 초안 작성. Step 3 TEE 무결성 검증 — 하드웨어 인증, 생성된 초안 및 분석 결과의 변조 여부를 하드웨어 수준에서 투명하게 검증. Step 4 Human-in-the-Loop — 최종 검토, AI의 환각을 방지하기 위해 교직원이 내용을 최종 검토 후 시스템 정식 반영, 검토 완료 도장 그림. RAG는 Retrieval-Augmented Generation(검색이 보강된 생성)이라는 주석

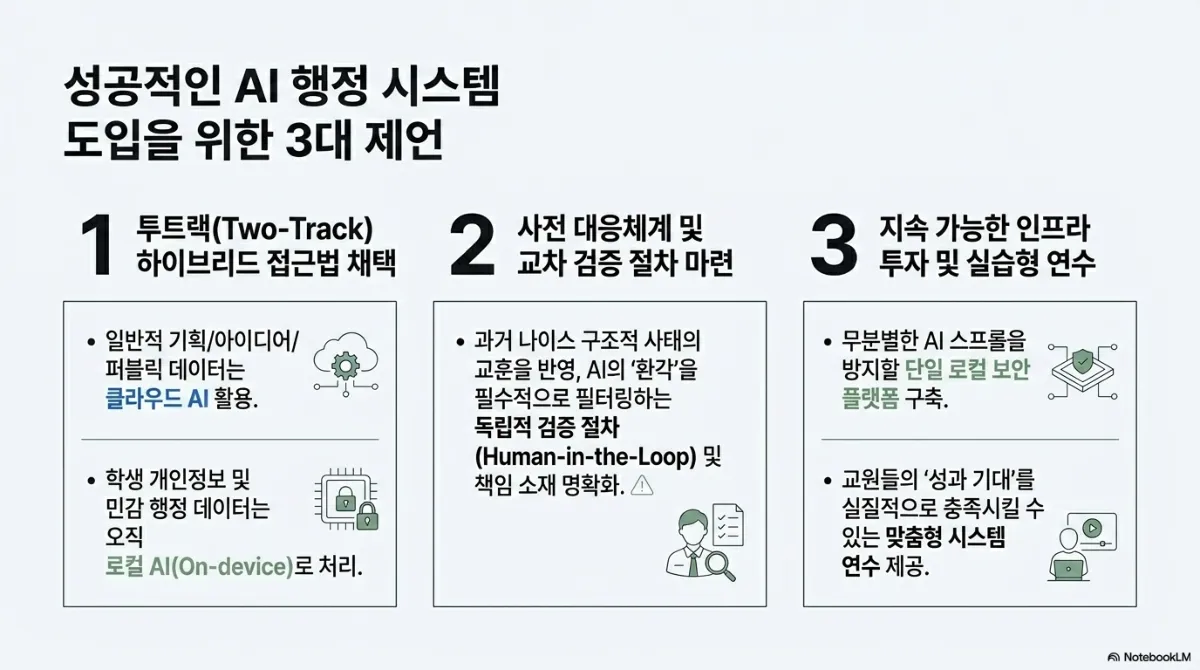
성공적인 AI 행정 시스템 도입을 위한 3대 제언. 1 투트랙(Two-Track) 하이브리드 접근법 채택 — 일반적 기획/아이디어/퍼블릭 데이터는 클라우드 AI 활용, 학생 개인정보 및 민감 행정 데이터는 오직 로컬 AI(On-device)로 처리. 2 사전 대응체계 및 교차 검증 절차 마련 — 과거 나이스 구조적 사태의 교훈을 반영해 AI의 환각을 필수적으로 필터링하는 독립적 검증 절차(Human-in-the-Loop) 및 책임 소재 명확화. 3 지속 가능한 인프라 투자 및 실습형 연수 — 무분별한 AI 스프롤을 방지할 단일 로컬 보안 플랫폼 구축, 교원들의 성과 기대를 실질적으로 충족시킬 수 있는 맞춤형 시스템 연수 제공

하드웨어 요건은 생각보다 문턱이 낮습니다. 자료 기준으로 VRAM 12GB급 GPU와 32GB 메모리면 중형 오픈소스 모델을 내부망에서 돌릴 수 있습니다. 실제 도입에서 더 어려운 것은 장비보다 어떤 데이터를 어느 트랙으로 보낼지 정하는 분류 기준입니다. 이 기준이 문서로 정해져 있지 않으면 교원 개인이 판단하게 되고, 결국 편한 쪽인 클라우드로 흘러갑니다. TEE와 콘텐츠 출처 인증은 아직 모든 기관이 갖추기 어려운 단계이므로, 우선은 망분리 로컬 서버와 최종 검토 절차부터 갖추는 것이 현실적인 순서로 보입니다.

자주 묻는 질문

로컬 AI는 ChatGPT보다 성능이 많이 떨어지나요? 범용 추론은 대형 클라우드 모델이 앞섭니다. 다만 공문 요약이나 초안 작성처럼 범위가 정해진 행정 업무는 중형 오픈소스 모델로도 충분한 경우가 많습니다.

어떤 데이터를 클라우드 AI에 넣어도 되나요? 이미 공개된 자료와 개인을 식별할 수 없는 기획 아이디어까지로 한정하는 것이 자료의 권고입니다. 학생 이름, 성적, 상담 내용은 로컬에서만 처리합니다.

학교마다 서버를 따로 둬야 하나요? 꼭 그렇지는 않습니다. 자료는 무분별한 도입을 막기 위해 교육청 단위의 단일 로컬 보안 플랫폼을 제안합니다. 운영과 연수 부담도 한곳에서 관리할 수 있습니다.

저희가 이 이야기를 하는 이유

에버스톤은 2013년부터 부산에서 앱과 웹·업무 시스템을 개발해 왔고, 학습 앱과 공공·기관 대상 시스템을 만들며 AI 도입 컨설팅도 하고 있습니다. 기관에 AI를 붙일 때 가장 먼저 묻는 것이 어떤 데이터가 밖으로 나가는가입니다. 이 자료의 투트랙 구성은 그 질문에 대한 정리된 답 가운데 하나라서 소개합니다.

인용한 수치(교사 338명 대상 UTAUT 분석, 나이스 성적 오류 규모, 서명·검증 오버헤드 표, 하드웨어 권장 사양)와 사례는 원 자료 기준이며, 저희가 검증한 내용이 아닙니다.

다른 글